


So sánh một số mô hình học máy trong dự báo chỉ số lạm phát Việt Nam
Lê Thị Thu Giang
Email: [email protected]
Nguyễn Thị Tuyết Mai
Email: [email protected]
Trường Đại học Thương mại
Tóm tắt
Dự báo lạm phát là một nội dung trọng yếu trong điều hành chính sách tiền tệ, do kết quả sự báo ảnh hưởng trực tiếp đến mục tiêu ổn định giá cả và kinh tế vĩ mô. Dữ liệu chuỗi thời gian giai đoạn 2010-2024 được sử dụng để huấn luyện và kiểm định mô hình mạng nơ-ron (RNN, LSTM) và các mô hình lai (LR-RNN, LR-LSTM) thông qua phương pháp hồi quy tuyến tính đa biến (LR). Kết quả thực nghiệm cho thấy các mô hình lai có ưu thế hơn so với các mô hình đơn lẻ trong dự báo lạm phát tại Việt Nam nhờ khả năng khai thác đồng thời các đặc điểm tuyến tính và phi tuyến của dữ liệu.
Từ khóa: Dự báo lạm phát, Việt Nam, học máy, hồi quy tuyến tính, mạng nơ-ron, mô hình lai, LR-LSTM
Summary
Inflation forecasting plays a crucial role in the implementation of monetary policy, as forecasting outcomes directly influence the objectives of price stability and macroeconomic stability. This study employs time-series data covering the period 2010-2024 to train and evaluate recurrent neural network models (RNN, LSTM) and hybrid models (LR-RNN, LR-LSTM) combined with multivariate linear regression (LR). The empirical results indicate that hybrid models outperform individual models in forecasting inflation in Viet Nam, as they are capable of simultaneously capturing both linear and nonlinear characteristics of the data.
Keywords: Inflation forecasting, Viet Nam, machine learning, linear regression, neural networks, hybrid models, LR-LSTM
GIỚI THIỆU
Việc duy trì ổn định giá cả là mục tiêu chính sách hàng đầu của các ngân hàng trung ương tại các quốc gia. Trong những thập kỷ qua, nhiều mô hình đã được các nhà khoa học nghiên cứu, phát triển và được đưa vào sử dụng ở các ngân hàng trung ương để dự báo các biến số kinh tế vĩ mô quan trọng như lạm phát, tăng trưởng GDP. Gần đây, công nghệ tính toán và các kỹ thuật thu thập, xử lý dữ liệu, các phương pháp học máy (Machine Learning - ML) ngày càng phát triển, được xem như những lựa chọn thay thế tiềm năng cho các mô hình dự báo thống kê truyền thống.
Tại Việt Nam, nhiều nghiên cứu cho thấy việc sử dụng các thuật toán ML hiện đại để dự báo lạm phát đã được thực hiện hiệu quả. Hiếu và cộng sự (2014) đã so sánh khả năng dự báo lạm phát giữa mô hình mạng nơ-ron tạo (ANN) và mô hình ARDL. Cùng chủ đề này, Xuân và cộng sự (2020) đã sử dụng các kỹ thuật như VAR, LASSO, KNN và mạng nơ-ron đa lớp (MLP) để xây dựng mô hình dự báo tăng trưởng kinh tế và lạm phát của Việt Nam bằng cách sử dụng dữ liệu thu thập từ năm 1996 đến 2021.
Việc dự báo chỉ số lạm phát cũng là một đề tài được nhiều nhà nghiên cứu ngoài nước quan tâm. Giannone và cộng sự (2008) đã sử dụng mô hình Factor-MIDAS kết hợp ML để dự báo lạm phát khu vực châu Âu. Mô hình này tận dụng dữ liệu tần suất cao, cho kết quả dự báo tốt hơn VAR (Vector Autoregression) truyền thống. Knotek và Zaman (2017) từ Cục Dự trữ Liên bang Cleveland đã thử nghiệm các mô hình ML để dự báo lạm phát tại Mỹ, qua đó nhận thấy rằng mô hình Ridge regression và Random Forest đạt độ chính xác cao hơn trong dự báo ngắn hạn. Tương tự, Boero và cộng sự (2020) sử dụng các thuật toán như SVM và k-NN để dự báo lạm phát ở cấp độ toàn cầu, cho thấy khả năng thích ứng tốt với dữ liệu có tính bất định cao.
Trong nhiều nghiên cứu trước đây, các mô hình tuyến tính truyền thống, đặc biệt là hồi quy tuyến tính, được sử dụng rộng rãi nhờ tính đơn giản và khả năng diễn giải cao, hiệu quả ổn định trong trường hợp dữ liệu có quy mô vừa và nhỏ. Tuy nhiên, khi xử lý các bộ dữ liệu lớn và có cấu trúc phức tạp, các phương pháp học máy thường đạt độ chính xác dự báo cao hơn. Hiệu quả tương đối giữa 2 nhóm phương pháp phụ thuộc đáng kể vào đặc điểm và quy mô của dữ liệu.
Mặc dù đã có nhiều nghiên cứu trong và ngoài nước về việc ứng dụng các thuật toán học máy trong dự báo lạm phát, nhưng chưa có nhiều công bố so sánh hiệu quả dự báo giữa các mô hình đó khi sử dụng bộ dữ liệu của Việt Nam. Do đó, nghiên cứu này này sẽ áp dụng và so sánh các phương pháp hồi quy tuyến tính đa biến, các mô hình mạng nơ-ron và các mô hình lai nhằm dự báo lạm phát tại Việt Nam với bộ dữ liệu thu thập theo tháng từ năm 2010 đến năm 2024.
CƠ SỞ LÝ THUYẾT
Các mô hình dự báo
Mô hình hồi quy tuyến tính (Linear Regression - LR)
Hồi quy tuyến tính là phương pháp cơ bản nhất trong kinh tế lượng để xác định mối quan hệ giữa biến phụ thuộc Y và các biến độc lập X. Trong mô hình này, các biến độc lập được giả định có mối quan hệ tuyến tính với biến phụ thuộc với sai số ngẫu nhiên єt:
Yt = β0 + β1X1,t + … + βkX{k,t} + єt
Các tham số của mô hình được ước lượng bằng phương pháp bình phương tối thiểu (OLS) nhằm cực tiểu hóa tổng bình phương sai số giữa giá trị thực tế và giá trị dự báo.
Mạng nơ-ron hồi tiếp (Recurrent Neural Networks - RNN)
Mạng nơ-ron hồi tiếp (RNN) là một lớp của mạng thần kinh nhân tạo được thiết kế đặc biệt để xử lý các dạng dữ liệu có tính thứ tự hoặc chuỗi thời gian. Nếu như các mạng thần kinh truyền thống thường giả định các đầu vào là độc lập với nhau, thì RNN có khả năng lưu giữ thông tin từ các bước thời gian trước đó nhờ vào các kết nối phản hồi (feedback loops).
Trạng thái ẩn (hidden state -ht) đóng vai trò như một bộ nhớ ngắn hạn trong mô hình. Tại mỗi bước thời gian t, ht được cập nhật dựa trên đầu vào hiện tại xt và trạng thái ẩn của bước trước đó ht-1 , cụ thể:
ht = f(Wh ht-1 + Wx xt +b)
Trong dự báo lạm phát, đặc tính này cho phép RNN nắm bắt được tính tự hồi quy của chuỗi số liệu, nơi mà mức giá của tháng này chịu ảnh hưởng trực tiếp từ diễn biến của các tháng trước đó. Tuy nhiên, nhược điểm của RNN là có thể sẽ gặp phải một trở ngại lớn được gọi là hiện tượng triệt tiêu đạo hàm. Khi chuỗi dữ liệu quá dài, thông tin từ quá khứ xa sẽ bị mất dần sức ảnh hưởng, khiến mô hình khó bắt được các chu kỳ kinh tế dài hạn.
Mạng bộ nhớ dài-ngắn hạn (Long-short term memory - LSTM)
Để khắc phục nhược điểm về trí nhớ ngắn hạn của RNN, Hochreiter và Schmidhuber (1997) đã đề xuất mô hình LSTM. Thành phần quan trọng nhất của LSTM là “trạng thái ô” Ct, có vai trò như một đường truyền thông tin xuyên suốt chạy dọc theo toàn bộ chuỗi thời gian. LSTM điều tiết thông tin chảy qua trạng thái ô này thông qua 3 loại cổng và sử dụng hàm kích hoạt Sigmoid để quyết định lượng thông tin được đi qua (từ 0 đến 1):
Cổng quên (Forget Gate -ft): Quyết định thông tin nào từ trạng thái ô trước đó không còn quan trọng và nên bị loại.
Cổng vào (Input Gate -it): Xác định những thông tin mới từ đầu vào hiện tại cần được lưu trữ vào trạng thái ô.
Cổng ra (Output Gate -0t): Trích xuất thông tin từ trạng thái ô hiện tại để tạo ra giá trị đầu ra và trạng thái ẩn cho bước tiếp theo.
Nhờ cơ chế điều tiết này, LSTM có khả năng duy trì các đặc điểm quan trọng của lạm phát như tính mùa vụ dài hạn hoặc tác động tích lũy của các chính sách tiền tệ qua nhiều năm mà không bị mất đi tín hiệu đạo hàm trong quá trình huấn luyện.
Các mô hình lai (Hybrid Models)
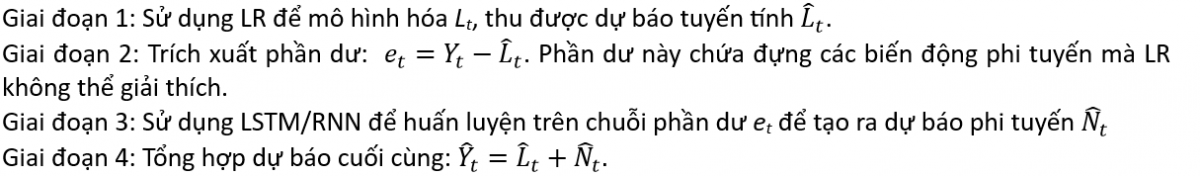
Mô hình lai được xây dựng dựa trên triết lý phân rã chuỗi thời gian, với giả định rằng dữ liệu lạm phát Yt là sự kết hợp của 2 thành phần độc lập: thành phần tuyến tính Lt và thành phần phi tuyến Nt, nghĩa là:
Yt = Lt + Nt.
Việc sử dụng mô hình lai giúp giải hiện tượng overfitting của các mạng thần kinh, đồng thời khắc phục sự cứng nhắc của mô hình hồi quy tuyến tính khi đối mặt với các cú sốc thị trường. Quy trình thực hiện mô hình LR-LSTM và LR-RNN như sau:
 |
Tiêu chuẩn đánh giá tính tốt của mô hình
Việc đánh giá mức độ phù hợp và hiệu quả của một mô hình có thể được thực hiện dựa trên nhiều tiêu chí khác nhau, tùy thuộc vào mục tiêu nghiên cứu và đặc điểm của dữ liệu. Các giá trị sau đây là căn cứ cho tính hiệu quả của dự báo:
Hệ số xác định R2
Hệ số xác định R2 là một trong những giá trị quan trọng để đánh giá độ phù hợp của mô hình, cho biết tỷ lệ phần trăm biến động của biến phụ thuộc được giải thích bởi các biến độc lập có trong mô hình. R2 càng gần 1, mô hình càng giải thích được nhiều sự biến động của lạm phát, chứng tỏ mô hình có độ khớp cao. Ngược lại, R2 gần 0 cho thấy mô hình không có khả năng giải thích các thay đổi của dữ liệu.
Sai số trung bình tuyệt đối (Mean Absolute Percentage Error- MAE)
MAE là một trong những chỉ số dùng để đo độ chính xác của dự báo, chỉ số này được tính toán theo công thức sau:
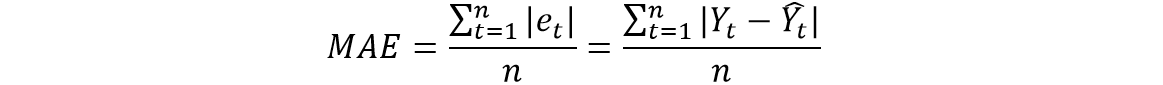 |
Trong đó: Yt là giá trị thực, Ŷt là giá trị dự báo, n là số thời kỳ.
MAE thể hiện mức sai số trung bình theo đơn vị của dữ liệu gốc, giúp dễ dàng diễn giải. Khi so sánh giữa các mô hình, mô hình nào có giá trị MAE nhỏ hơn thì được xem là mô hình tốt hơn, vì sai số dự báo trung bình của nó thấp hơn.
Sai số phần trăm tuyệt đối trung bình đối xứng (symmetric Mean Absolute Percentage Error - sMAPE)
sMAPE là một biến thể cải tiến của chỉ số MAPE (Mean Absolute Percentage Error), nhằm được sử dụng để đánh giá độ chính xác của các mô hình dự báo lạm phát trong nghiên cứu này. Giá trị sMAPE được tính theo công thức sau:
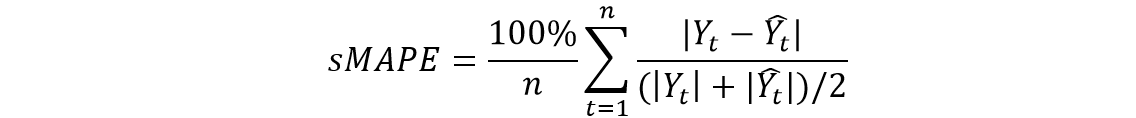 |
Giá trị của sMAPE càng thấp thì kết quả dự báo được đánh giá càng tốt. Cụ thể:
sMAPE < 10%: Dự báo rất tốt;
10% < sMAPE < 20%: Dự báo tốt;
20% < sMAPE < 50%: Dự báo chấp nhận được.
PHƯƠNG PHÁP NGHIÊN CỨU
Các dữ liệu được thu thập theo tháng từ năm 2010-2014 trên trang web của Tổng cục Thống kê (nay là Cục Thống kê, Bộ Tài chính), bao gồm các chỉ số lạm phát (tính theo chỉ số giá tiêu dùng) và các chỉ số có tác động quan trọng tới lạm phát là giá vàng trong nước, giá USD, yếu tố mùa vụ là Tết (khi tiêu dùng tăng đột biến). Các chỉ số này được chọn làm biến độc lập cùng với biến trễ của chỉ số lạm phát, giá vàng và giá USD. Dữ liệu sau khi chuẩn hóa có thể sử dụng được chia thành 2 phần: Tập huấn luyện bao gồm các dữ liệu từ năm 2010-2023 và tập kiểm tra bao gồm các dữ liệu của năm 2024.
Nghiên cứu sử dụng cách viết số thập phân theo chuẩn quốc tế.
KẾT QUẢ NGHIÊN CỨU
Nhóm tác giả tiến hành giải bài toán dự báo chỉ số lạm phát bằng phần mềm Python trên Google Colab cho các mô hình Hồi quy tuyến tính (LR), RNN và LSTM. Đồng thời, để nâng cao hiệu quả trong dự báo, tác giả cũng đã thử nghiệm với các mô hình lai giữa mô hình LR với RNN và LSTM (LR-LSTM và LR-RNN). Để tránh hiện tượng overfitting, nhóm tác giả đã sử dụng kỹ thuật “dừng sớm” (early stopping) khi chạy thuật toán, nghĩa là các vòng lặp sẽ được dừng khi thấy sai số trên tập kiểm tra tăng lên. Kết quả kiểm tra sai số và độ phù hợp của mô hình trên tập huấn luyện và tập kiểm tra được thể hiện trong Bảng.
Bảng: So sánh sai số và hệ số R2
| Mô hình | MAE (%) | sMAPE (%) | R² Train | R² Test |
|---|---|---|---|---|
| LSTM | 0.7105 | 16.50% | 0.85 | 0.35 |
| RNN | 0.8421 | 19.50% | 0.78 | 0.25 |
| LR | 0.5342 | 12.40% | 0.62 | 0.60 |
| LR-LSTM | 0.4855 | 10.50% | 0.88 | 0.68 |
| LR-RNN | 0.5120 | 11.20% | 0.82 | 0.64 |
Nguồn: Các tác giả tính toán
Từ Bảng 1, có thể khi so sánh giữa các mô hình đơn lẻ, mô hình Hồi quy tuyến tính (LR) cho kết quả dự báo chính xác hơn các mô hình mạng nơ-ron nhân tạo. Cụ thể, mặc dù hệ số R2 trên tập huấn luyện của các mô hình mạng nơ-ron khá cao, với 0.78 cho RNN và 0.85 cho LSTM, nhưng giá trị này trên tập kiểm tra thấp, với kết quả lần lượt là 0.25 và 0.35 cho 2 mô hình trên. Trong khi đó, kết quả nhận được cho phương pháp LR cho cả tập huấn luyện và tập kiểm tra đều không < 0.6. Bên cạnh đó, sai số MAE và sMAPE của phương pháp LR cũng nhỏ hơn 2 phương pháp RNN và LSTM. Có 2 lý do quan trọng: Thứ nhất, bộ dữ liệu khá nhỏ, chỉ chưa tới 200 quan sát, tương ứng với dữ liệu thu thập của 15 năm (mỗi năm có 12 tháng) nên không đủ để các thuật toán phức tạp như RNN hay LSTM học được các tham số một cách tối ưu và dễ dẫn đến hiện tượng overfiting. Thứ hai, do bản chất kinh tế của biến Lạm phát. Biến này có xu hướng phụ thuộc tuyến tính theo các biến độc lập đã lựa chọn bao gồm các biến trễ, giá vàng, giá USD. Do đó, mô hình hồi quy tuyến tính thể hiện tốt mối quan hệ này hơn các mô hình RNN hay LSTM. Ngoài ra, do tính đơn giản của mô hình, kết quả khi thực hiện hồi quy tuyến tính thường bỏ qua các biến động nhỏ để bám theo xu hướng chính, trong khi các phương pháp học máy thường mô tả rất sát dữ liệu, do tính phi tuyến của nó. Điều này dễ dẫn tới hiện tượng overfitting, nghĩa là sai số trên tập huấn luyện rất thấp, nhưng sai số trên tập kiểm tra lại rất cao. Các mô hình lai sẽ khai thác lợi thế của cả mô hình phi tuyến và tuyến tính. Điều này thể hiện ưu thế trong đánh giá sai số cũng như giá trị của hệ số xác định. Sai số khi sử dụng LR-LSTM là nhỏ nhất trong tất cả cả phương pháp, trong khi giá trị R2 trên cả tập huấn luyện và tập kiểm tra đều đạt mức cao nhất (lần lượt là 0.88 và 0.68). Mô hình LR-RNN cũng cho kết quả tốt với các giá trị sai số và R2 khá gần với mức của mô hình LR-RNN đạt được.
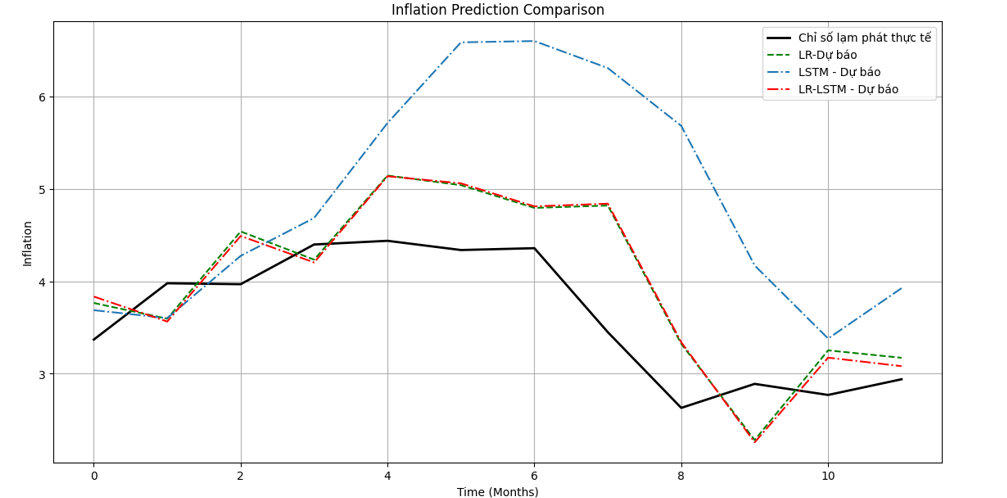
Hình 1: So sánh các kết quả dự báo LR, LSTM, RL-LSTM và dữ liệu thực tế
 |
Nguồn: Tính toán của nhóm tác giả
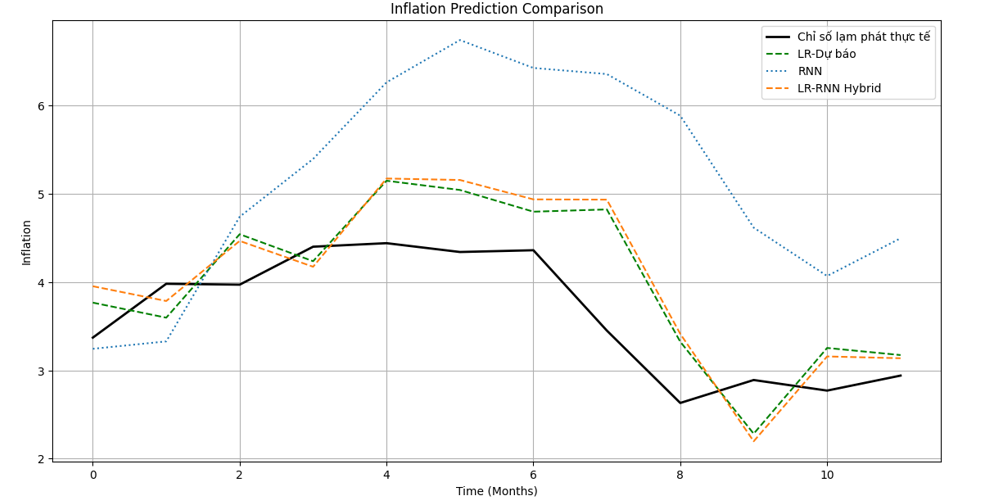
Hình 1 so sánh kết quả dự báo bằng các phương pháp LR, LSTM và RL-LSTM với giá trị thực tế của chỉ số lạm phát tại Việt Nam trên tập kiểm tra của dữ liệu (từ tháng 1 đến cuối tháng 11 năm 2024). Có thể thấy mô hình lai cho kết quả tốt nhất khi đường dự báo (đường màu đỏ) nằm khá sát với dữ liệu thực tế. Đường dự báo của mô hình LR (đường màu xanh lá) cũng mô tả khá tốt giá trị thực tế, trong khi kết quả dự báo bằng phương pháp LSTM (đường màu xanh nước biển) có sai lệch tương đối lớn trong khoảng thời gian từ tháng 6-8/2024, cũng là thời điểm lạm phát thực tế biến động khá mạnh. Kết quả tương tự khi so sánh giữa các phương pháp LR, RNN và RL-RNN (Hình 2). Như vậy, thông qua các thử nghiệm kể trên, ta thấy ưu thế của các mô hình lai so với các mô hình đơn lẻ khi sử dụng trong bài toán dự báo với bộ dữ liệu có kích thước không lớn.
Hình 2: So sánh các kết quả dự báo LR, RNN, LR-RNN và dữ liệu thực tế
 |
Nguồn: Tính toán của nhóm tác giả
KẾT LUẬN
Kết quả nghiên cứu cho thấy các mô hình kết hợp giữa hồi quy tuyến tính và mạng nơ-ron (đặc biệt là LR-LSTM) cho kết quả dự báo bám sát thực tế nhất, đạt hiệu quả cao nhất, trong đó, R2 cao nhất trong khi các sai số MAE và sMAPE thấp nhất. Khi so sánh giữa các mô đơn lẻ, mô hình hồi quy tuyến tính (LR) cho độ chính xác cao hơn RNN và LSTM thuần túy. Nguyên nhân chủ yếu do kích thước mẫu hiện tại (dưới 200 quan sát) chưa đủ lớn để các mạng nơ-ron tối ưu tham số, đồng thời lạm phát Việt Nam vẫn duy trì xu hướng phụ thuộc tuyến tính mạnh vào các biến như giá vàng và tỷ giá. Việc tích hợp các phương pháp kinh tế lượng truyền thống với các kỹ thuật học máy hiện đại tạo ra một khung phân tích linh hoạt và đáng tin cậy hơn so với việc sử dụng từng phương pháp riêng lẻ. Sự kết hợp này cho phép khai thác đồng thời cấu trúc tuyến tính và phi tuyến của dữ liệu, qua đó cải thiện đáng kể độ chính xác dự báo. Những phát hiện này không chỉ đóng góp về mặt phương pháp luận mà còn gợi mở hướng tiếp cận hiệu quả trong công tác dự báo và điều hành chính sách tiền tệ tại Việt Nam.
Tài liệu tham khảo:
1. Bandara, K., Bergmeir, C., & Smyl, S. (2020). Forecasting across time series databases using recurrent neural networks on groups of similar series: A clustering approach. Expert Systems with Applications, 140, 112896.
2. Boero, G., Jalles, J. T., & Sousa, R. M. (2020). Can machine learning forecast inflation? Evidence from a global perspective. Journal of Forecasting, 39(7), 1049-1068.
3. Giannone, D., Lenza, M., & Primiceri, G. E. (2008). Exploiting the monthly data flow in structural forecasting. ECB Working Paper Series, No. 852.
4. Hiếu, N.K. & Anh, N.T.V. (2014). Dự báo lạm phát tại Việt Nam bằng mô hình mạng thần kinh nhân tạo. Journal of Asian Business and Economic Studies, 286, 15--35.
5. Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735-1780. https://doi.org/10.1162/neco.1997.9.8.1735
6. Knotek, E. S., & Zaman, S. (2017). Nowcasting U.S. headline and core inflation. Journal of Money Credit and Banking, 49(5), 931-968.
7. Nhật, N.T. (2022). Forecasting Inflation Rate Using Artificial Neural Network: A Case Study of Vietnam. Hue University Journal of Science: Economics and Development, 131(5B), 63-74.
8. Xuân, P.T.T., Trang, C.T.T, Duy, N.T., Trang, B.H. & Ngọc, T. T. B. (2020). Ứng dụng mạng nơ ron nhân tạo để dự báo lạm phát: Nghiên cứu tình huống tại Việt Nam. Tạp chí nghiên cứu Tài chính, 58, 54-66.
| Ngày nhận bài: 1/2/2026; Ngày hoàn thiện biên tập: 10/3/2026; Ngày duyệt đăng: 13/3/2026 |
Tin liên quan



Các tin khác

Các yếu tố ảnh hưởng đến ý định chuyển đổi từ xe máy xăng sang xe máy điện của sinh viên ngoại tỉnh tại Hà Nội

Phát triển doanh nghiệp logistics tại Việt Nam: Thực trạng và kiến nghị

Chia sẻ tri thức, phong cách lãnh đạo và hành vi làm việc đổi mới của nhân viên ngành du lịch - lữ hành Hà Nội

Ảnh hưởng của công bố thông tin ESG đến năng lực huy động vốn và hiệu quả tài chính của các doanh nghiệp thủy sản xuất khẩu tại Việt Nam

Thực trạng các yếu tố ảnh hưởng đến hỗ trợ của doanh nghiệp nhỏ và vừa do phụ nữ làm chủ trên địa bàn TP. Hà Nội và giải pháp tăng cường hỗ trợ

Ảnh hưởng của chất lượng tương tác doanh nghiệp đến kiến thức nghề nghiệp và niềm tin năng lực bản thân của sinh viên: Nghiên cứu tại Trường Cao đẳng Dược Hà Nội

Nguồn lực công nghệ trong các ngành công nghiệp sáng tạo Việt Nam: Từ ứng dụng đến làm chủ công nghệ

Yếu tố ảnh hưởng đến ý định sử dụng xe buýt điện của học sinh, sinh viên tại TP. Hồ Chí Minh

Chính sách quản lý về phát triển chính quyền số tại Hà Tĩnh: Thực trạng và giải pháp


