


Học máy trong phát hiện gian lận rửa tiền: Bằng chứng thực nghiệm và một số hàm ý quản trị cho các ngân hàng thương mại
Nguyễn Vũ Hoàng Ý
Nguyễn Anh Tú (tác giả liên hệ)
Email: [email protected]
Viện Nghiên cứu khoa học và Công nghệ ngân hàng, Trường Đại học Ngân hàng TP. Hồ Chí Minh
Tóm tắt
Nghiên cứu này đánh giá hiệu quả của các thuật toán học máy trong phát hiện giao dịch rửa tiền dựa trên bộ dữ liệu SAML-D gồm khoảng 9,5 triệu giao dịch trên nền tảng trực tuyến Kaggle. Hai mô hình Random Forest và XGBoost được sử dụng để phân loại giao dịch hợp pháp và giao dịch đáng ngờ. Kết quả cho thấy cả 2 mô hình đều dự báo tốt, trong đó XGBoost có khả năng phát hiện giao dịch rửa tiền hiệu quả hơn. Các yếu tố như giá trị giao dịch, vị trí ngân hàng gửi - nhận và loại hình thanh toán có ảnh hưởng đáng kể đến khả năng nhận diện rửa tiền.
Từ khóa: Rửa tiền, học máy, phân loại, Random Forest, XGBoost
Summary
This study evaluates the effectiveness of machine learning algorithms for detecting money laundering transactions using the SAML-D dataset, comprising approximately 9.5 million transactions on the Kaggle platform. Two models, Random Forest and XGBoost, are employed to classify legitimate and suspicious transactions. The results indicate that both models demonstrate strong predictive performance, with XGBoost exhibiting superior ability to detect money laundering activities. Factors such as transaction value, the locations of sending and receiving banks, and payment types significantly influence the detection of money laundering.
Keywords: Money laundering, machine learning, classification, Random Forest, XGBoost
GIỚI THIỆU
Ngành ngân hàng đang phát triển nhanh các hệ thống tài chính số, các nền tảng thanh toán hiện đại mang lại tiện ích và tiết kiệm thời gian cho khách hàng (Jolly, 2016). Tuy nhiên, xu hướng này cũng làm gia tăng nhanh chóng các hành vi tội phạm mạng, khiến các hình thức gian lận trong lĩnh vực ngân hàng trở nên tinh vi và khó lường hơn (Mangala và Soni, 2023). Trong bối cảnh đó, học máy (Machine Learning - ML) trở thành một công cụ hiệu quả giúp phân tích dữ liệu giao dịch, nhận diện các mẫu hành vi bất thường và hỗ trợ ngân hàng phát hiện sớm giao dịch đáng ngờ. Vì vậy, nghiên cứu này tập trung đánh giá khả năng ứng dụng học máy trong phát hiện giao dịch rửa tiền và gợi ý một số hàm ý cho các ngân hàng thương mại.
CÁC NGHIÊN CỨU LIÊN QUAN
Học máy đã được đề xuất và triển khai rộng rãi như một lớp công cụ bổ sung cho các hệ thống giám sát giao dịch truyền thống vì khả năng phát hiện mẫu phức tạp và xử lý quy mô lớn dữ liệu giao dịch. Tuy nhiên, nhiều nghiên cứu nhấn mạnh rằng lợi ích thực tế của học máy với vấn đề phòng, chống rửa tiền (Anti-Money Laundering - AML) phụ thuộc chặt chẽ vào tính sẵn có và chất lượng của dữ liệu huấn luyện. Trong nhiều bối cảnh tổ chức, tiềm năng này vẫn chưa được hiện thực hóa đầy đủ do thiếu nhãn, dữ liệu lịch sử có chất lượng và các ràng buộc tổ chức liên quan đến việc chia sẻ dữ liệu (Canhoto, 2021). Ngoài ra, độ đa dạng và sự tiến hóa liên tục của thủ đoạn rửa tiền khiến các mô hình dễ bị lạc hậu nếu không có cơ chế cập nhật liên tục (Canhoto, 2021).
Trong thực nghiệm, bộ dữ liệu có gắn nhãn đã trở thành cơ sở cho nhiều nghiên cứu nhằm kiểm định hiệu năng các phương pháp học máy khác nhau và so sánh khả năng của những mô hình đề xuất với các mô hình bảng truyền thống. Kết quả cho thấy, phương pháp đồ thị (như GCN, GAT) có lợi thế khi cần khai thác thông tin quan hệ giữa các địa chỉ/giao dịch, song các mô hình kết hợp và cây quyết định vẫn thường cho hiệu suất cạnh tranh trong một số tập dữ liệu thực nghiệm (Weber và cộng sử, 2019). Cụ thể, thuật toán Rừng Ngẫu nhiên (Random Forest - RF) thường được đánh giá cao về tính ổn định và khả năng giải thích thông qua đo lường mức độ quan trọng của biến, trong khi XGBoost lại thể hiện ưu thế về độ chính xác dự báo nhờ cơ chế sửa lỗi tịnh tiến liên tục theo từng cây quyết định (Chen và Guestrin, 2016). Ngoài ra, các mô hình này còn được tối ưu hóa tham số trong các thuật toán lai nhằm nâng cao hiệu quả phát hiện của các mô hình phức tạp (Anh Tu và cộng sự, 2024).
Bảng 1: Tổng hợp một số nghiên cứu chính về chủ đề học máy áp dụng cho rửa tiền
| Nghiên cứu | Bộ dữ liệu sử dụng | Mô hình/Phương pháp | Chỉ số đánh giá | Độ chính xác & Hạn chế chính | Khoảng trống nghiên cứu |
| Tiwari và cộng sự (2020)
| Tổng hợp dữ liệu thứ cấp từ Scopus, ProQuest, ScienceDirect và các báo cáo OCCRP, FATF, IMF. | Lược khảo hệ thống -phân loại 6 hướng nghiên cứu chính (khung phòng, chống rửa tiền, truy dấu, ảnh hưởng…) | Không có chỉ số định lượng. | Tổng quan toàn diện, nhưng chưa có thực nghiệm; chỉ dừng ở tổng hợp định tính. | Thiếu nghiên cứu thực tế về giao dịch xuyên biên giới và đo lường hiệu quả mô hình AML. |
| Lokanan (2024)
| Dữ liệu mô phỏng | Naïve Bayes, Random Forest, Artificial Neural Network (ANN)
| Accuracy, Confusion Matrix, ROC Curve. | RF & Naïve Bayes có Độ phân tán cao; ANN tăng Độ nhạy nhưng độ ổn định thấp. Dữ liệu mô phỏng nên độ tin cậy chưa cao. | Cần dữ liệu thật, đa miền và kết hợp học sâu với các mô hình giải thích được. |
| Gupta và cộng sự (2022) | Dữ liệu thật từ 4 ngân hàng (châu Á & Âu) + 2.000 trường hợp SAR mô phỏng. | Phân tích chất lượng dữ liệu và định nghĩa sự kiện (event definition); hồi quy thống kê và phân tích hành vi. | Không tính Độ chính xác; đánh giá theo khoảng dự đoán. | Cải thiện tốc độ dự báo khi xác định đúng thời điểm SAR, nhưng chưa lượng hóa tác động. | Thiếu dữ liệu chuẩn hóa và nhất quán giữa các tổ chức; cần khung chuẩn cho phòng, chống rửa tiền. |
| Jensen và Losifidis (2023)
| Tổng hợp nhiều nghiên cứu; dữ liệu thực tế 2 triệu 819.000 bản ghi từ các ngân hàng. | Tổng hợp mô hình theo 2 nhóm: Client Risk Profiling (K-means, Logistic Regression, Autoencoder) và Suspicious Behavior Flagging (Decision Tree, SVM, XGBoost, Deep Learning). | Độ phân tán, Độ nhạy và giá trị SHAP. | Mô hình phân cụm phát hiện tình trạng bất thường tốt; mô hình hồi quy Logistic dễ giải thích. Vấn đề này còn thiếu dữ liệu công khai và tiêu chuẩn đánh giá chưa thống nhất. | Cần nghiên cứu về học bán giám sát, tính công bằng, khả năng diễn giải và tiêu chuẩn tập dữ liệu tổng hợp. |
Nguồn: Tổng hợp của các tác giả
Tổng quan lý thuyết và các nghiên cứu trước cho thấy việc ứng dụng học máy trong phát hiện rửa tiền đã được đề cập ở nhiều quốc gia nhưng chủ yếu tập trung vào các thuật toán truyền thống như Hồi quy Logistic và RF. Đồng thời, các nghiên cứu còn hạn chế trong việc phân tích vấn đề mất cân bằng dữ liệu và mối quan hệ giữa độ nhạy và tỷ lệ âm tính sai khi áp dụng trong thực tế. Đặc biệt, kiểm chứng hiệu quả của mô hình XGBoost trên bộ dữ liệu SAML - D và liên hệ với bối cảnh ngân hàng thương mại vẫn còn ít được nghiên cứu. Vì vậy, nghiên cứu này thực hiện thực nghiệm mô hình XGBoost trên dữ liệu SAML - D để đánh giá khả năng phát hiện giao dịch rửa tiền thông qua các chỉ số Diện tích dưới đường cong (Area Under Curve - AUC), Độ nhạy (Recall), Độ phân tán (Precision) và điểm số F1 (F1-score); đồng thời đề xuất một số hàm ý ứng dụng cho các ngân hàng thương mại trong triển khai hệ thống phòng, chống rửa tiền.
PHƯƠNG PHÁP NGHIÊN CỨU
Dữ liệu nghiên cứu
Bộ dữ liệu sử dụng trong nghiên cứu là SAML-D (Synthetic Anti-Money Laundering Dataset), bao gồm 9.504.852 giao dịch tài chính được sinh tổng hợp dựa trên các kịch bản giao dịch thực tế. Trong đó, chỉ có khoảng 9.875 giao dịch (tương đương 0,1%) được gắn nhãn là rửa tiền (Suspicious Transactions), còn lại 99,9% là giao dịch hợp pháp (Non-Laundering Transactions). Bộ dữ liệu bao gồm 13 biến, trong đó 12 biến độc lập mô tả thông tin chi tiết của giao dịch và 1 biến phụ thuộc Laundering biểu thị trạng thái rửa tiền. Các biến định tính được mã hóa để phù hợp với khả năng chạy thuật toán học máy, trong khi biến định lượng như Amount được biến đổi log nhằm giảm độ lệch chuẩn và cải thiện hiệu quả học của mô hình.
Bảng 2: Mô tả chi tiết các biến
| Tên biến | Kiểu dữ liệu | Mô tả |
| Laundering | Phân loại nhị phân | Được ghi nhận theo dữ liệu lịch sử, với 1: có xảy ra hiện tượng rửa tiền; 0: không có hiện tượng rửa tiền |
| Sender_account | Dạng phân loại (chuỗi mã hóa) | Mã tài khoản gửi tiền (mã hóa bằng Label Encoding). |
| Receiver_account | Dạng phân loại (chuỗi mã hóa) | Mã tài khoản nhận tiền (mã hóa bằng Label Encoding). |
|
Amount |
Số thực (float) | Giá trị tiền giao dịch; được log-transform để giảm độ lệch phân phối. |
|
Payment_type |
Dạng phân loại | Phương thức thanh toán: Credit card, Debit card, ACH, Cheque, Cross- border, Cash Deposit, Cash Withdrawal. |
| Payment_currency | Dạng phân loại | Loại tiền tệ của giao dịch (ví dụ: USD, EUR, GBP…). |
|
Received_currency |
Dạng phân loại | Loại tiền tệ của tài khoản nhận (có thể trùng hoặc khác loại). |
| Sender_bank_loca | Dạng phân loại | Quốc gia hoặc khu vực ngân hàng gửi. |
| Receiver_bank_loca | Dạng phân loại | Quốc gia hoặc khu vực ngân hàng nhận. |
| Hour | Số nguyên | Giờ thực hiện giao dịch (0-23). |
| Date_Year | Số nguyên | Năm thực hiện giao dịch (2022–2023). |
| Date_Month | Số nguyên | Tháng thực hiện giao dịch. |
| Date_Day | Số nguyên | Ngày thực hiện giao dịch. |
Nguồn: Kaggle.com
Thực trạng mất cân bằng dữ liệu là điều phổ biến trong các bộ dữ liệu phát hiện gian lận rửa tiền, phản ánh thực tế các hành vi phạm pháp trong môi trường giao dịch thực tế. Sự mất cân bằng nghiêm trọng này đặt ra một thách thức lớn đối với các thuật toán học máy. Các mô hình phân loại tiêu chuẩn có xu hướng thiên lệch về lớp chiếm đa số (99,9%). Hệ quả là, mô hình có thể dễ dàng đạt được độ chính xác rất cao nhưng lại thất bại trong việc phân loại chính xác các trường hợp thuộc lớp thiểu số. Điều này dẫn đến độ nhạy (Recall) thấp cho lớp rửa tiền, đồng nghĩa với việc mô hình bỏ sót (False Negatives) một lượng lớn các giao dịch rửa tiền thực tế. Do đó, việc áp dụng các kỹ thuật xử lý mất cân bằng và lựa chọn các chỉ số đánh giá phù hợp là yếu tố then chốt để xây dựng một mô hình phát hiện rửa tiền hiệu quả.
Nghiên cứu này sử dụng kỹ thuật lấy mẫu quá mức thiểu số tổng hợp (SMOTE) để xử lý mất cân bằng lớp bằng cách can thiệp trực tiếp vào không gian đặc trưng. Về cơ chế, SMOTE tạo mẫu mới bằng cách nội suy tuyến tính giữa một điểm thiểu số và các láng giềng gần nhất (k-nearest neighbors) cùng lớp. Do đó, các điểm tổng hợp nằm bên trong vùng quyết định của lớp thiểu số, làm cho biên phân tách của mô hình học máy ít thiên lệch hơn so với trường hợp chỉ lặp lại dữ liệu cũ. Cách tiếp cận này giúp giảm hiện tượng quá khớp (overfitting) thường gặp khi lấy mẫu ngẫu nhiên quá mức (random oversampling), đồng thời cải thiện đáng kể độ nhạy (Recall) của lớp thiểu số (Chawla và cộng sự, 2002).
Quy trình xây dựng và đánh giá mô hình học máy phát hiện gian lận rửa tiền
Bước 1 - thu thập và làm sạch dữ liệu: Nghiên cứu sử dụng bộ dữ liệu gồm 9.504.852 giao dịch với 12 biến đầu vào, trong đó chỉ khoảng 0,1% được gắn nhãn rửa tiền (Laundering = 1). Dữ liệu được kiểm tra giá trị thiếu, loại bỏ bản ghi trùng, chuẩn hóa định dạng nhằm bảo đảm tính nhất quán toàn bộ tập dữ liệu. Nhóm tác giả sử dụng các công cụ Pandas, matplotlib và Seaborn để thống kê mô tả và trực quan hóa dữ liệu.
Bước 2 - tiền xử lý dữ liệu: Các biến phân loại được mã hóa bằng Label Encoding, trong khi các biến số lượng được chuẩn hóa bằng StandardScaler. Toàn bộ quy trình xử lý, huấn luyện, đánh giá được thực hiện bằng ngôn ngữ lập trình Python trên môi trường Google Colab.
Bước 3 - xây dựng mô hình học máy: Mô hình được lựa chọn là XGBoost Classifier (Extreme Gradient Boosting) và so sánh kết quả với thuật toán rừng ngẫu nhiên.
Bước 4 - đánh giá mô hình: Mô hình được đánh giá bằng các chỉ số định lượng theo bài toán phân loại để đánh giá chất lượng thuật toán.
Các mô hình học máy và chỉ số đo lường chất lượng mô hình
Nghiên cứu này sử dụng 2 mô hình học máy thuộc lớp cây quyết định và mô hình học tổng hợp là mô hình RF và XGBoost. Trong đó, RF lựa chọn phương án tốt nhất bằng cách bầu chọn đa số, và XGBoost lựa chọn phương án tốt nhất bằng cách cập nhật lỗi từ các quyết định trước.
Về các chỉ số đo lường chất lượng phân loại, nghiên cứu này dùng các chỉ số trong ma trận nhầm lẫn, bao gồm: Độ chính xác (Accuracy), Độ chụm (Precision), Độ nhạy (Recall), điểm F1 (F1-score), và diện tích dưới đường cong ROC (AUC) được coi là thước đo chung về khả năng phân biệt của mô hình (Nguyen và cộng sự, 2021).
KẾT QUẢ THỰC NGHIỆM
Mô tả dữ liệu
Hình 1 minh họa tính đa dạng của hành vi rửa tiền, cho thấy sự phân bố rộng từ các giao dịch giá trị rất nhỏ (gần 0) cho đến các điểm ngoại lai (outliers). Phần lớn sự xuất hiện của các giao dịch cực lớn thường liên quan đến các giao dịch xuyên biên giới. Kết quả đồng thời cho thấy việc phân bố số tiền rộng và không tạo thành cụm rõ ràng sẽ không thể phát hiện hiệu quả. Do đó, cần phải sử dụng một mô hình học máy phi tuyến tính (ví dụ: mô hình XGBoost) có khả năng nắm bắt các mẫu giao dịch tinh vi ở mức thấp và nhạy cảm với các giao dịch ngoại lai có rủi ro cao.
Hình 1: Phân bố giá trị các giao dịch nghi ngờ rửa tiền
 |
Nguồn: Tính toán của nhóm tác giả
Ma trận tương quan tại Hình 2 cho thấy phần lớn các biến trong bộ dữ liệu có mức tương quan thấp với biến mục tiêu Laundering, phản ánh đúng bản chất khó dự đoán và tính phức tạp của hành vi rửa tiền. Việc nhãn rửa tiền (Laundering) không thể hiện tương quan tuyến tính cao với bất kỳ đặc trưng đơn lẻ nào chứng minh rằng hoạt động rửa tiền mang tính phi tuyến cao. Hành vi gian lận chỉ có thể được nhận diện khi kết hợp đồng thời nhiều biến số và dựa trên các mối quan hệ phức tạp. Vì vậy, các mô hình học máy phi tuyến tính như XGBoost phù hợp hơn so với các mô hình tuyến tính truyền thống, vì chúng có khả năng học các mối quan hệ phức tạp và đa chiều giữa các đặc trưng.
Hình 2: Ma trận tương quan giữa các biến đặc trưng
 |
Nguồn: Tính toán của nhóm tác giả
Kết quả phân loại
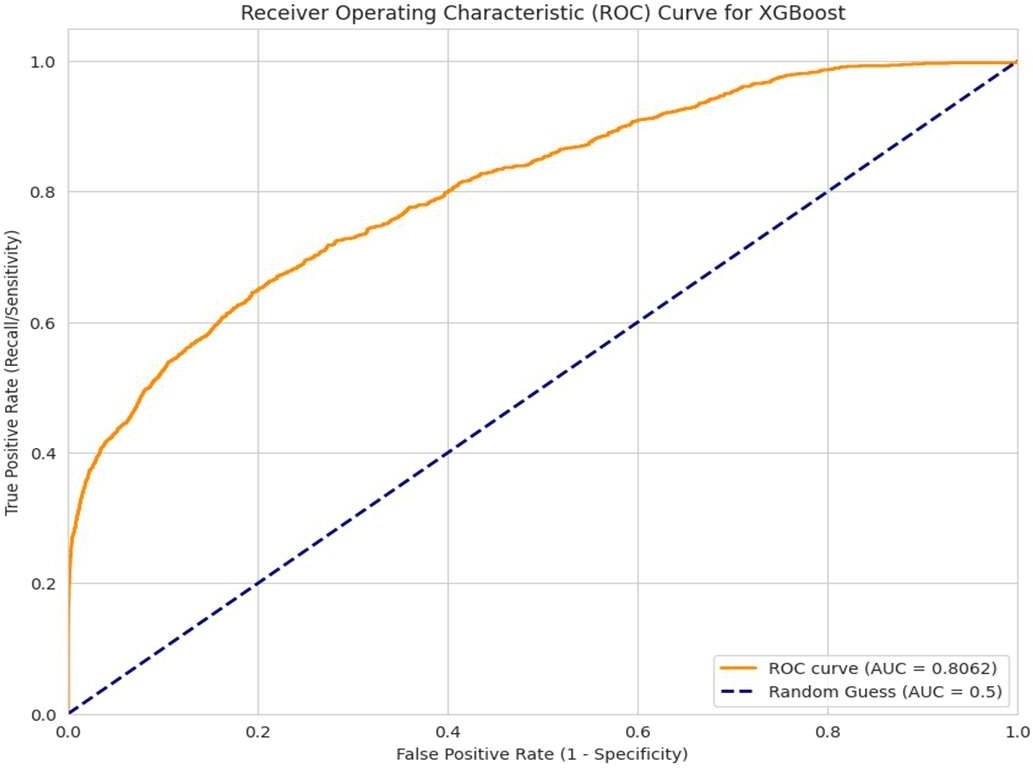
Bảng 2 cho thấy độ chính xác của 2 mô hình đều cao; khả năng phân biệt các trường hợp Dương tính đúng và Âm tính đúng trong tổng thể của cả 2 mô hình đều tốt. Trong đó, XGBoost nhỉnh hơn với độ chính xác, phù hợp với giả thuyết về khả năng dự báo tốt của mô hình XGBoost. Các Chỉ số Độ phân tán và Độ nhạy có độ tương đồng nhất định và chỉ số F1 của XGBoost tiếp tục tốt hơn so với RF, cho thấy khả năng cân bằng giữa chỉ số Độ phân tán và Độ nhạy của mô hình XGboost tốt hơn. Ngoài ra, chỉ số Diện tích dưới đường cong (Area Under Curve - AUC) của XGBoost đạt 0,8062, cao hơn rõ rệt so với RF. AUC cao hơn khẳng định rằng XGBoost có khả năng phân biệt giữa giao dịch rửa tiền và giao dịch hợp pháp tốt hơn RF.
Bảng 2: Kết quả phân loại theo các phương pháp khác nhau
| Phương pháp | Accuracy | Precision | Recall | F1-score | AUC-ROC |
| Rừng ngẫu nhiên | 98,02% | 93,40% | 88,87% | 0,9108 | 0,7121 |
| XGBoost | 99,01% | 93,36% | 89,84% | 0,9157 | 0,8062 |
Nguồn: Tổng hợp từ kết quả nghiên cứu
Hình 3 cho thấy đường cong ROC (Receiver Operating Characteristic) mô tả mối quan hệ giữa Tỷ lệ Dương tính đúng (tức là tỷ lệ giao dịch rửa tiền thật được phát hiện đúng) và Tỷ lệ Dương tính sai (tức là tỷ lệ giao dịch hợp pháp bị gắn nhầm là rửa tiền) tại các ngưỡng dự đoán khác nhau. Đường chéo màu xanh biểu diễn mô hình ngẫu nhiên, trong đó TPR tăng tương ứng với FPR (mỗi khi phát hiện thêm một giao dịch rửa tiền thì đồng thời cũng gắn nhầm thêm một giao dịch hợp pháp), cho thấy mô hình không mang lại giá trị phân loại thực sự. Ngược lại, đường cong ROC của XGBoost nằm phía trên đường chéo này và ôm sát góc trái phía trên, chứng tỏ mô hình có khả năng duy trì Tỷ lệ Dương tính đúng ở mức cao trong khi vẫn giữ Tỷ lệ Dương tính sai tương đối thấp. Chỉ số AUC đạt 0,8062 đóng vai trò là chỉ số tổng hợp đánh giá chất lượng phân loại của mô hình trên toàn bộ dải ngưỡng dự đoán, thay vì chỉ tại một điểm ngưỡng cố định. Về mặt xác suất, AUC = 0,81 nghĩa là nếu chọn ngẫu nhiên một giao dịch rửa tiền và một giao dịch hợp pháp, xác suất để mô hình xếp hạng giao dịch rửa tiền có mức độ “nghi ngờ” cao hơn giao dịch hợp pháp là khoảng 81%. Giá trị này vượt xa mức 0,5 của mô hình ngẫu nhiên và được xem là hiệu năng tốt trong bối cảnh dữ liệu mất cân bằng (lớp rửa tiền chỉ chiếm 0,1% tổng số giao dịch).
Hình 3: Đường cong ROC và giá trị AUC của mô hình XGBoost
 |
Nguồn: Tính toán của nhóm tác giả
Đáng chú ý, việc đạt AUC > 0,8 trong một bài toán mà các đặc trưng không thể hiện tương quan tuyến tính rõ ràng với nhãn rửa tiền cho thấy XGBoost đã khai thác hiệu quả các mối quan hệ phi tuyến và tương tác giữa nhiều biến (số tiền, loại giao dịch, vị trí ngân hàng, thời gian giao dịch…). Điều này chứng minh rằng mô hình không chỉ học tốt hành vi của các giao dịch thông thường, mà còn nhận diện được các mẫu hành vi rửa tiền hiếm gặp nằm ở phần “đuôi” của phân phối dữ liệu, vốn là điểm yếu của các phương pháp thống kê tuyến tính truyền thống. Nói cách khác, đường cong ROC và giá trị AUC = 0,81 là bằng chứng định lượng cho thấy XGBoost là mô hình đáng cân nhắc để làm nền tảng cho hệ thống giám sát giao dịch rửa tiền dựa trên học máy.
KẾT LUẬN
Nghiên cứu này đã thử nghiệm nền tảng và chứng minh tiềm năng của thuật toán học máy XGBoost trong việc hỗ trợ hệ thống giám sát giao dịch, đạt hiệu suất phân biệt tương đối tốt với Chỉ số Diện tích dưới đường cong (AUC) trên bộ dữ liệu SAML-D. Kết quả về AUC là tích cực. Nghiên cứu cũng làm nổi bật thách thức với bộ dữ liệu của ngành ngân hàng trong vấn đề phòng, chống rửa tiền. Việc ứng dụng học máy tại các ngân hàng thương mại vẫn đối mặt với các rào cản lớn: chất lượng dữ liệu thấp do phụ thuộc vào hệ thống gắn nhãn truyền thống (rule-based). Để khắc phục, giải pháp không chỉ dừng lại ở việc tối ưu hóa thuật toán, còn cần tăng tính minh bạch như triển khai kết hợp học máy giải thích (Explainable AI - XAI) như SHAP/LIME. Cụ thể, kết hợp đồng bộ giữa Dữ liệu lớn + Học máy + XAI sẽ tạo nên giải pháp cho vấn đề phòng, chống rửa tiền toàn diện, mang lại bước tiến quan trọng cho các ngân hàng thương mại. Cụ thể, dữ liệu lớn và xử lý theo thời gian thực cho phép theo dõi hàng triệu giao dịch theo thời gian thực với độ trễ thấp nhất. Các phương pháp học máy giúp nhận diện rủi ro và các phương pháp AI giải thích được kết quả đầu ra của chương trình. Điều này làm tăng tính giám sát theo thời gian thực, tăng tính chính xác và tăng khả năng giải thích cho các mô hình học máy, đáp ứng yêu cầu ngày càng cao của cơ quan quản lý về phòng, chống rửa tiền.
Tài liệu tham khảo:
1. Anh-Tu, N., Khoa, D. D., Nhan, N. C. T., & Oanh, D. (2024). Hybrid ARIMA and machine learning approach for the VND/USD exchange rate prediction in Vietnam: A comparative analysis. In Partial Identification in Econometrics and Related Topics (587–604): Springer.
2. Canhoto, A. I. (2021). Leveraging machine learning in the global fight against money laundering and terrorism financing: An affordances perspective. Journal of business research, 131, 441–452.
3. Chawla, N. V., Bowyer, K. W., Hall, L. O., & Kegelmeyer, W. P. (2002). SMOTE: synthetic minority over-sampling technique. Journal of artificial intelligence research, 16, 321–357.
4. Chen, T., & Guestrin, C. (2016). Xgboost: A scalable tree boosting system. Paper presented at the Proceedings of the 22nd acm sigkdd international conference on knowledge discovery and data mining.
5. Gupta, A., Dwivedi, D. N., Shah, J., & Jain, A. (2022). Data quality issues leading to sub optimal machine learning for money laundering models. Journal of Money Laundering Control, 25(3), 551–555.
6. Jensen, R. I. T., & Iosifidis, A. (2023). Fighting money laundering with statistics and machine learning. Ieee Access, 11, 8889–8903.
7. Jolly, V. (2016). The influence of internet banking on the efficiency and cost savings for banks’ customers. International Journal of Social Sciences and Management, 3(3), 163–170.
8. Lokanan, M. E. (2024). Predicting money laundering using machine learning and artificial neural networks algorithms in banks. Journal of Applied Security Research, 19(1), 20–44.
9. Mangala, D., & Soni, L. (2023). A systematic literature review on frauds in banking sector. Journal of Financial Crime, 30(1), 285–301.
10. Nguyen, A.-T., Lu, S.-H., & Nguyen, P. T. T. (2021). Validating and forecasting carbon emissions in the framework of the environmental Kuznets curve: the case of Vietnam. Energies, 14(11), 3144.
11. Tiwari, M., Gepp, A., & Kumar, K. (2020). A review of money laundering literature: the state of research in key areas. Pacific Accounting Review, 32(2), 271–303.
12. Weber, M., Domeniconi, G., Chen, J., Weidele, D. K. I., Bellei, C., Robinson, T., & Leiserson, C. E. (2019). Anti-money laundering in bitcoin: Experimenting with graph convolutional networks for financial forensics. arXiv preprint arXiv:1908.02591
| Ngày nhận bài: 28/1/2026; Ngày hoàn thiện biên tập: 10/3/2026; Ngày duyệt đăng: 16/3/2026 |
Tin liên quan



Các tin khác

Phối hợp chính sách tài khóa, tiền tệ và khả năng tiếp cận vốn của doanh nghiệp nhỏ và vừa Việt Nam: Cơ chế truyền dẫn và hàm ý chính sách

Vai trò bổ sung của tỷ giá USD/CNY trong việc giải thích biến động thị trường chứng khoán Việt Nam: Bằng chứng giai đoạn 2015-2026

Cân bằng minh bạch tài chính công và bảo mật dữ liệu: Kinh nghiệm quốc tế và hàm ý cho Việt Nam

Các yếu tố ảnh hưởng đến quyết định sử dụng thẻ tín dụng của Gen Z tại Ngân hàng thương mại cổ phần Sài Gòn Tài Lộc - Chi nhánh Thủ Đức

Hiệu quả tài chính từ chức năng trung gian tài chính của ngân hàng thương mại trong bối cảnh ứng dụng công nghệ thông tin và truyền thông

Các yếu tố ảnh hưởng đến chất lượng dịch vụ ngân hàng số và xu hướng tiếp tục sử dụng của khách hàng cá nhân tại tỉnh Vĩnh Long

Phân bổ nguồn lực tài chính theo vòng đời khu công nghiệp: Bằng chứng từ Nghệ An và hàm ý phát triển bền vững

Kế toán lưu ký và tự doanh tài sản mã hóa: So sánh Việt Nam với thông lệ quốc tế

Các yếu tố ảnh hưởng đến quyết định tiếp tục sử dụng thanh toán điện tử của khách hàng hộ kinh doanh tại BIDV khu vực Đức Trọng


