


Dự báo hành vi rời bỏ khách hàng B2B bằng học máy trong bối cảnh thương mại điện tử tại Việt Nam
TS. Dương Thị Hoàn
Trường Kinh tế, Đại học Công nghiệp Hà Nội
Email: [email protected]
Tóm tắt
Trong bối cảnh thương mại điện tử B2B tại Việt Nam ngày càng phát triển, bài viết này nghiên cứu ứng dụng các mô hình học máy nhằm dự báo hành vi rời bỏ khách hàng, từ đó giúp doanh nghiệp xây dựng chiến lược giữ chân hiệu quả. Phạm vi nghiên cứu được thực hiện tập trung vào nhóm khách hàng sỉ hoặc đại lý có giao dịch với các doanh nghiệp bán hàng trên sàn thương mại điện tử Shopee Việt Nam. Hai mô hình được triển khai gồm Hồi quy Logistic và Rừng ngẫu nhiên (Random Forest). Kết quả cho thấy, Logistic Regression đạt độ chính xác 84%, F1-score 0.85 cho nhóm rời bỏ, vượt trội hơn Random Forest trong bối cảnh bài toán. Mô hình Logistic cũng có ưu điểm là dễ giải thích, giúp xác định các yếu tố tác động như số lượng hashtag sau đơn hàng cuối cùng, mức chiết khấu cập nhật, hay tần suất gọi điện. Từ đó, bài viết đề xuất các giải pháp chiến lược cho bộ phận Marketing, CRS và Phân tích dữ liệu trong doanh nghiệp. Kết quả nghiên cứu góp phần khẳng định tính khả thi và giá trị ứng dụng của học máy trong tối ưu hóa quản trị khách hàng B2B tại Việt Nam.
Từ khóa: Học máy, rời bỏ khách hàng, thương mại điện tử B2B
Abstract
In the context of the rapid development of B2B e-commerce in Viet Nam, the study investigates the application of machine learning models for predicting customer churn behavior, thereby helping enterprises develop effective customer retention strategies. The scope of this study focuses on wholesale customers or agents who conduct transactions with businesses selling on the Shopee Vietnam e-commerce platform. Two models are implemented, namely Logistic Regression and Random Forest. The results show that Logistic Regression achieves an accuracy of 84% and an F1-score of 0.85 for the churn class, outperforming Random Forest in this problem setting. The Logistic model also demonstrates advantages in interpretability, enabling the identification of key influencing factors such as the number of hashtags used after the last order, updated discount levels, and call frequency. Based on these findings, the study proposes strategic solutions for the Marketing, CRS, and Data Analytics departments within the enterprise. The research results contribute to confirming the feasibility and practical value of machine learning in optimizing B2B customer management in Viet Nam.
Keywords: Machine learning, customer churn, B2B e-commerce
GIỚI THIỆU
Trong kỷ nguyên số, thương mại điện tử đã trở thành nền tảng chính yếu cho các doanh nghiệp, tạo ra khối lượng dữ liệu hành vi khách hàng khổng lồ mỗi ngày. Việc xử lý hiệu quả và khai thác dữ liệu đó là cơ sở để ra quyết định trong môi trường kinh doanh cạnh tranh ngày nay (McAfee và E. Brynjolfsson, 2012; Zhang và cộng sự, 2023).. Nổi bật nhất trong các kỹ thuật đó là các mô hình học máy (ML), vốn đã được áp dụng rộng rãi trong phân tích và dự báo hành vi khách hàng, đặc biệt là dự báo hành vi rời bỏ (churn), yếu tố ảnh hưởng lớn đến doanh thu và hiệu quả tiếp cận thị trường (Sunarya và cộng sự, 2024).
Khách hàng B2B trong thương mại điện tử, đặc biệt tại Việt Nam, thường có chu kỳ giao dịch dài, phụ thuộc vào các yếu tố như chiết khấu, dịch vụ hậu mãi và tương tác tư vấn. Theo các nghiên cứu gần đây, chi phí để giữ chân một khách hàng hiện hữu cao hơn rất nhiều so với chi phí thu hút khách hàng mới (Li, 2024). Do đó, việc dự báo hành vi rời bỏ không chỉ giúp doanh nghiệp chủ động trong chiến lược giữ chân, mà còn quyết định đến sự bền vững và tăng trưởng dài hạn.
Gần đây, mô hình Logistic Regression và Random Forest đã thể hiện ưu thế nổi bật trong bài toán phân loại churn trong thương mại điện tử. Ví dụ, nghiên cứu năm 2024 trên tập dữ liệu e‑commerce đã so sánh hiệu suất hai mô hình này, kết quả cho thấy Random Forest vượt trội hơn Logistic Regression với độ chính xác và AUC‑ROC cao hơn đáng kể 95% và 90% accuracy; AUC‑ROC lần lượt 0.97 và 0.88 (Sunarya và cộng sự, 2024). Một đánh giá toàn diện khác năm 2025 cũng chỉ ra rằng sự kết hợp hai mô hình nói trên với các kỹ thuật cân bằng dữ liệu như SMOTE giúp tăng đáng kể khả năng phát hiện churn (Ren, 2025; Tuhin Subhra De và cộng sự, 2024).
Tuy nhiên, hầu hết các nghiên cứu hiện tại tập trung vào môi trường B2C hoặc các ngành viễn thông, ngân hàng. Việc áp dụng ML trong dự báo churn cho khách hàng B2B tại Việt Nam nơi dữ liệu chưa được khai thác đầy đủ vẫn còn rất hạn chế. Đây chính là khoảng trống mà bài báo này hướng đến.
Hai mô hình học máy là Logistic Regression và Random Forest sẽ được triển khai trên cơ sở dữ liệu từ năm 2024 gồm các biến đặc trưng như số đơn hàng, tần suất tương tác, phản hồi khách hàng sau tư vấn và mức chiết khấu. Với sự kết hợp giữa mô hình dễ giải thích (Logistic Regression) và mô hình phi tuyến mạnh (Random Forest), nghiên cứu kỳ vọng xây dựng một công cụ hỗ trợ chiến lược chăm sóc khách hàng, đồng thời cung cấp bằng chứng thực nghiệm về ứng dụng ML trong lĩnh vực thương mại điện tử B2B tại Việt Nam.
CƠ SỞ LÝ THUYẾT
Trong ngành thương mại điện tử, dự báo hành vi rời bỏ khách hàng (churn) là vấn đề then chốt để tối ưu hoá quy trình quản trị và bảo toàn doanh thu. Nghiên cứu của Jingyuan Li (2024) ứng dụng Logistic Regression, Random Forest, XGBoost và LightGBM trên một bộ dữ liệu thương mại điện tử công khai. Kết quả chỉ ra rằng, Random Forest đạt area‑under‑ROC (AUC) lên tới 0.985, vượt trội so với các mô hình còn lại. Nghiên cứu còn kết hợp xử lý mất cân bằng dữ liệu bằng SMOTE và giải thích kết quả dùng SHAP/LIME để xác định các nhân tố ảnh hưởng churn (Li, 2024).
Haoran Ren (2025) xây dựng một hệ thống dự báo gồm Logistic Regression, Random Forest, GBDT và một mô hình stacking dùng XGBoost làm meta‑learner, đạt accuracy 92.8% và AUC 0.94 trên tập dữ liệu từ Kaggle. Nghiên cứu nhấn mạnh tầm quan trọng của các biến như độ hài lòng, thời gian tương tác (recency) và khiếu nại trong dự báo churn (Ren, 2025). Haoran Ren cũng so sánh trực tiếp Logistic Regression và Random Forest, cho thấy rừng ngẫu nhiên thường cho kết quả tốt hơn khi xử lý các tập dữ liệu đa chiều, tương tác phức tạp (Ren, 2025).
Nghiên cứu gần đây trên B2B e‑commerce sử dụng dữ liệu tương tác theo tuần và các mô hình học máy (Logistic, Random Forest, SVM). Kết quả cho thấy, phân tích dữ liệu chuỗi thời gian giúp nhận diện tín hiệu rời bỏ một cách kịp thời hơn so với chỉ sử dụng dữ liệu tĩnh (Tuhin Subhra De và cộng sự, 2024). Tuhin Subhra De và cộng sự (2024) đề xuất phương pháp kết hợp XGBoost và mô hình Poisson‑Gamma để dự báo hành vi đặt hàng trong B2B e‑commerce (trường hợp Udaan - Ấn Độ), đạt tăng gấp 3 lần tần suất đặt đơn sau khi áp dụng mô hình (Sunarya và cộng sự, 2024). Nghiên cứu khẳng định giá trị mô hình ensemble mạnh trong bối cảnh B2B, nơi tương tác giữa khách hàng và bên bán phức tạp.
Nhiều tập dữ liệu churn bị mất cân bằng nặng (dữ liệu “churn” chiếm tỷ lệ thấp). Li (2024) và Ren (2025) đều sử dụng kỹ thuật SMOTE để cải thiện khả năng nhận dạng khách rời bỏ. Đồng thời, các phương pháp giải thích mô hình như SHAP và LIME giúp doanh nghiệp hiểu rõ yếu tố chính ảnh hưởng đến churn và đưa ra chiến lược phù hợp.
Tổng hợp các nghiên cứu trên cho thấy, Random Forest và các mô hình ensemble như XGBoost thường vượt trội hơn về độ chính xác và khả năng xử lý dữ liệu phức tạp. Việc xử lý mất cân bằng dữ liệu và giải thích mô hình là yếu tố quan trọng để áp dụng thực tiễn. Do vậy, bài báo này sẽ so sánh hiệu suất giữa Logistic Regression và Random Forest trên dữ liệu B2B Việt Nam. Áp dụng kỹ thuật SMOTE để cân bằng dữ liệu và SHAP để giải thích kết quả. Tăng độ chính xác dự báo, hỗ trợ đưa ra chiến lược giữ chân khách hàng hiệu quả trong mảng B2B thương mại điện tử tại Việt Nam.
PHƯƠNG PHÁP NGHIÊN CỨU
Mô tả bộ dữ liệu
Tập dữ liệu được thu thập trong giai đoạn từ tháng 01/2024 đến tháng 4/2025, phản ánh các đặc trưng hành vi của khách hàng sỉ đã tương tác và mua hàng qua các chiến dịch quảng cáo trên Facebook và TikTok. Bộ dữ liệu gồm 952 dòng và 11 cột, tương ứng với 952 quan sát và 11 biến đặc trưng phục vụ cho bài toán dự báo rời bỏ khách hàng (Nghiên cứu sử dụng cách viết số thập phân theo chuẩn quốc tế).
Bảng 1: Mô tả các biến trong tập dữ liệu
| STT | Tên biến | Kiểu và giá trị | Miêu tả |
|---|---|---|---|
| 1 | dpn_spbiid | int | ID của bản ghi sản phẩm người bán |
| 2 | dpn_userid | smallint | ID người dùng |
| 3 | dpn_spbicityid | smallint | Nhóm sản phẩm tiếp cận |
| 4 | discountrate | bigint | Tỷ lệ chiết khấu (%) |
| 5 | totalcompleted_after_upload | bigint | Tổng số đơn hoàn thành sau khi upload |
| 6 | total_hashtag_full_after_last_order | int | Tổng hashtag đầy đủ kể từ đơn hàng cuối |
| 7 | total_hashtag_after_last_order | int | Tổng hashtag kể từ đơn hàng cuối |
| 8 | total_calls_before_last_order | int | Tổng số cuộc gọi trước đơn hàng cuối |
| 9 | last_status | bigint | Trạng thái gần nhất của người dùng |
| 10 | update_discountrate | bigint | Tỷ lệ chiết khấu được cập nhật gần đây |
| 11 | total_calls_after_last_order | bigint | Tổng số cuộc gọi sau đơn hàng cuối |
Ghi chú: Cột last_status được gán lại nhãn nhằm chuẩn hóa định dạng cho bài toán phân loại nhị phân. Cụ thể, trạng thái “rời bỏ” được gán giá trị 1, trong khi trạng thái “không rời bỏ” được gán giá trị 0. Cột discountrate được chuyển đổi về dạng số thập phân nhằm phục vụ cho quá trình xử lý và phân tích dữ liệu định lượng.
Nguồn: Phân tích từ dữ liệu nghiên cứu
Chia tập dữ liệu
Việc chia tập dữ liệu là bước thiết yếu trong quá trình xây dựng mô hình học máy nhằm đảm bảo đánh giá khách quan hiệu suất dự báo hành vi rời bỏ khách hàng. Sau khi hoàn tất quá trình tiền xử lý và chuẩn hoá, tập dữ liệu bao gồm 10 biến đầu vào đặc trưng phản ánh hành vi tương tác và mức độ ưu đãi của người dùng (như discountrate, total_calls_before_last_order, totalcompleted_after_upload...) cùng với biến mục tiêu là last_status đại diện cho trạng thái rời bỏ hay tiếp tục sử dụng dịch vụ của khách hàng.
Các biến không mang giá trị dự báo như dpn_spbiid (ID đơn hàng) đã được loại bỏ để tránh ảnh hưởng đến quá trình huấn luyện. Dữ liệu sau xử lý bao gồm 952 quan sát, được chia theo tỷ lệ 80:20 trong đó 80% dữ liệu dùng để huấn luyện mô hình, còn 20% còn lại được dùng để kiểm tra. Cách chia này bảo đảm rằng, mô hình có đủ dữ liệu để học được các mẫu hành vi đa dạng từ tập huấn luyện, đồng thời cung cấp một tập kiểm tra độc lập đủ lớn để đánh giá năng lực tổng quát hoá của mô hình trong thực tế.
Xây dựng mô hình
Trong nghiên cứu này, hai mô hình học máy được triển khai và đánh giá gồm: Hồi quy logistic (Logistic Regression) và Rừng ngẫu nhiên (Random Forest). Đây là hai thuật toán phổ biến và hiệu quả trong các bài toán phân loại nhị phân, đặc biệt là trong bối cảnh phân tích hành vi người dùng và dự đoán khả năng rời bỏ.
Mô hình hồi quy logistic
Hồi quy logistic được sử dụng như một mô hình cơ sở (baseline model) nhằm kiểm tra khả năng dự đoán hành vi rời bỏ dựa trên các đặc trưng hành vi đầu vào. Mô hình được huấn luyện trên tập dữ liệu chuẩn hóa, sử dụng biến mục tiêu last_status (0 – rời bỏ, 1 – còn hoạt động). Hệ số hồi quy cho từng biến đầu vào cho phép đánh giá mức độ ảnh hưởng tuyến tính của từng yếu tố đến xác suất khách hàng tiếp tục sử dụng dịch vụ.
Mô hình Rừng ngẫu nhiên
Mô hình Random Forest một tập hợp nhiều cây quyết định huấn luyện theo nguyên tắc bagging được sử dụng để tăng độ chính xác và giảm hiện tượng overfitting. Rừng ngẫu nhiên có khả năng mô hình hóa quan hệ phi tuyến tính giữa các biến đầu vào và nhãn mục tiêu, đồng thời cung cấp chỉ số quan trọng (feature importance) của từng biến trong quá trình ra quyết định.
Đánh giá hiệu suất mô hình
Cả hai mô hình được đánh giá trên tập kiểm tra thông qua các chỉ số:
- Precision (Độ chính xác theo lớp): Mức độ chính xác khi dự đoán khách hàng sẽ rời bỏ.
- Recall (Độ bao phủ): Tỷ lệ phát hiện đúng khách hàng thực sự rời bỏ.
- F1-score: Trung bình điều hòa của precision và recall.
KẾT QUẢ VÀ ĐÁNH GIÁ MÔ HÌNH NGHIÊN CỨU
Bảng 2: Kết quả đánh giá hiệu suất mô hình hồi quy Logistic
| Label | Precision | Recall | F1-Score | Support |
|---|---|---|---|---|
| 0 (Không rời bỏ) | 0.81 | 0.84 | 0.82 | 85 |
| 1 (Rời bỏ) | 0.86 | 0.84 | 0.85 | 106 |
| Accuracy |
|
| 0.84 | 191 |
| Macro Avg | 0.84 | 0.84 | 0.84 | 191 |
| Weighted Avg | 0.84 | 0.84 | 0.84 | 191 |
Nguồn: Phân tích từ dữ liệu nghiên cứu
Bảng 2 thể hiện kết quả đánh giá hiệu suất của mô hình Logistic Regression trên tập kiểm tra gồm 191 mẫu dữ liệu. Tổng độ chính xác (accuracy) của mô hình đạt 0.84, cho thấy khả năng phân loại tổng thể khá tốt trong bối cảnh dự báo hành vi rời bỏ khách hàng B2B trong thương mại điện tử tại Việt Nam.
Cụ thể, đối với lớp 0 (không rời bỏ), mô hình đạt độ chính xác (precision) 0.81, độ bao phủ (recall) 0.84 và điểm F1 0.82, cho thấy khả năng nhận diện tương đối hiệu quả các khách hàng duy trì hoạt động. Trong khi đó, đối với lớp 1 (rời bỏ) nhóm mục tiêu chính trong nghiên cứu, mô hình đạt precision 0.86, recall 0.84 và F1-score 0.85. Kết quả này cho thấy mô hình có khả năng phát hiện chính xác và đầy đủ các trường hợp khách hàng rời bỏ, vốn là một chỉ số quan trọng đối với các chiến lược giữ chân khách hàng và cải thiện hiệu suất kinh doanh.
Các chỉ số macro average và weighted average của precision, recall và F1-score đều đạt 0.84, phản ánh sự cân bằng giữa hai lớp cũng như tính ổn định trong quá trình huấn luyện và đánh giá mô hình. Logistic Regression dù là một mô hình tuyến tính cơ bản vẫn cho thấy hiệu quả tương đối tốt trong bối cảnh bài toán này.
Bảng 3: Kết quả đánh giá hiệu suất mô hình Random Forest
| Lớp | Precision | Recall | F1-Score | Support |
|---|---|---|---|---|
| Không rời bỏ (0) | 0.7927 | 0.7647 | 0.7784 | 85 |
| Rời bỏ (1) | 0.8165 | 0.8396 | 0.8279 | 106 |
| Macro avg | 0.8046 | 0.8022 | 0.8032 | 191 |
| Weighted avg | 0.8059 | 0.8063 | 0.8059 | 191 |
Nguồn: Phân tích từ dữ liệu nghiên cứu
Sau khi huấn luyện mô hình và đánh giá trên tập kiểm tra, kết quả cho thấy mô hình đạt độ chính xác (accuracy) là 80.63%, thể hiện khả năng phân loại tương đối tốt. Cụ thể, đối với lớp 0 (không rời bỏ), precision đạt 0.79 và recall là 0.76, trong khi lớp 1 (rời bỏ) có precision cao hơn ở mức 0.82 và recall đạt 0.84. Chỉ số F1-score lần lượt là 0.78 cho lớp không rời bỏ và 0.83 cho lớp rời bỏ, phản ánh mức độ cân bằng hợp lý giữa độ chính xác và khả năng phát hiện đúng các mẫu của mô hình. Bên cạnh đó, macro average và weighted average của các chỉ số precision, recall và f1-score đều xấp xỉ 0.80, cho thấy mô hình hoạt động ổn định và không thiên lệch nhiều về phía bất kỳ lớp nào. Những kết quả này cho thấy mô hình hiện tại có tiềm năng ứng dụng trong bài toán dự đoán rời bỏ khách hàng, tuy nhiên có thể tiếp tục được cải thiện để nâng cao độ chính xác cho lớp không rời bỏ.
So sánh hiệu suất giữa hai mô hình là Logistic Regression và Random Forest, mặc dù Random Forest cho khả năng phát hiện khách rời bỏ khá tốt (recall đạt 83.96%), Logistic Regression lại cho kết quả tổng thể vượt trội hơn với độ chính xác lên đến 84% và F1-score cho lớp rời bỏ đạt 0.85 cao hơn so với 0.8279 của Random Forest. Ngoài ra, Logistic Regression có ưu điểm nổi bật là dễ triển khai, giải thích rõ ràng và cho phép doanh nghiệp hiểu rõ vai trò của từng yếu tố đầu vào thông qua hệ số hồi quy. Với sự cân bằng tốt giữa hiệu quả phân loại và tính minh bạch, mô hình Logistic Regression được lựa chọn là phương án phù hợp nhất cho bài toán này.
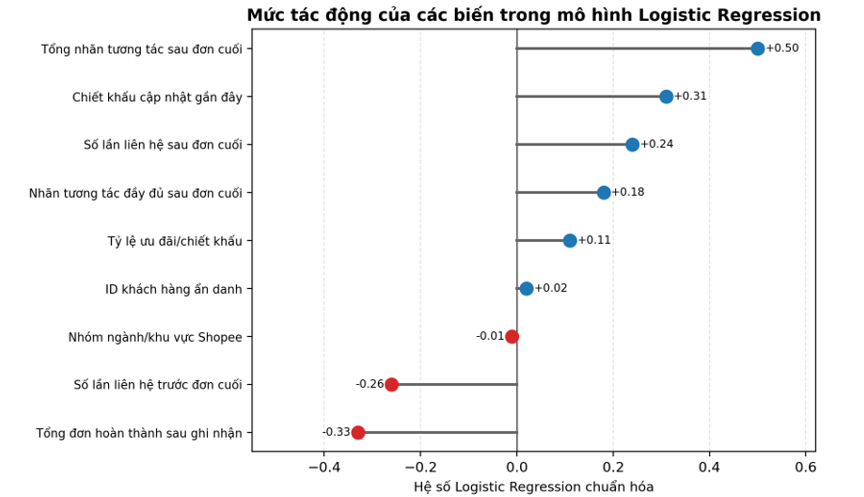
Hình minh họa hệ số ảnh hưởng của từng đặc trưng đầu vào đến xác suất dự đoán hành vi rời bỏ khách hàng. Các đặc trưng có hệ số lớn (dương hoặc âm) cho thấy mức độ tác động mạnh đến quyết định của mô hình.
Hình: Ảnh hưởng của các biến đặc trưng tới ý định của khách hàng theo Logistic Regression
 |
Nguồn: Phân tích từ dữ liệu nghiên cứu
Hình 2 thể hiện mức độ ảnh hưởng của các đặc trưng đến biến mục tiêu trong mô hình dự báo. Mỗi đặc trưng được biểu diễn bằng một thanh ngang, với chiều dài và chiều hướng của thanh thể hiện mức độ và chiều hướng ảnh hưởng dương hoặc âm đến hành vi khách hàng.
Kết quả cho thấy đặc trưng có ảnh hưởng lớn nhất là total_hashtag_after_last_order, với hệ số ảnh hưởng lên tới +0.50. Điều này cho thấy khi số lượng hashtag được sử dụng sau đơn hàng gần nhất tăng lên, khả năng khách hàng thực hiện hành vi mục tiêu cũng tăng mạnh. Đây là yếu tố then chốt trong mô hình. Ngược lại, các đặc trưng như totalcompleted_after_upload và total_calls_before_last_order lại có hệ số ảnh hưởng âm lần lượt là -0.16 và -0.14, cho thấy nếu khách hàng hoàn thành nhiều hành vi sau khi tải lên, hoặc có nhiều cuộc gọi trước đơn hàng cuối cùng, thì khả năng xảy ra hành vi mục tiêu sẽ giảm xuống. Điều này có thể phản ánh sự giảm hứng thú hoặc bị làm phiền từ phía khách hàng.
Ngoài ra, các yếu tố như update_discountrate và total_calls_after_last_order cũng có ảnh hưởng tích cực, tuy ở mức độ vừa phải. Các đặc trưng như dpn_userid và dpn_spbicityid lại có hệ số ảnh hưởng gần như bằng 0, cho thấy chúng không đóng vai trò đáng kể trong mô hình.
Từ đó có thể kết luận rằng một số hành vi cụ thể sau đơn hàng cuối cùng, đặc biệt là việc sử dụng hashtag và cập nhật giảm giá, có tác động tích cực đến khả năng khách hàng tiếp tục tương tác hoặc mua hàng. Những đặc trưng ít ảnh hưởng có thể được cân nhắc loại bỏ để đơn giản hóa mô hình và cải thiện hiệu suất tính toán.
KẾT LUẬN VÀ GIẢI PHÁP
Kết luận
Sau khi xây dựng mô hình hồi quy Logistic để dự đoán hành vi rời bỏ của khách hàng, nhóm tác giả tiến hành phân tích hệ số ảnh hưởng của từng đặc trưng (biến đầu vào) đến biến mục tiêu. Kết quả cho thấy một số đặc trưng có vai trò đáng kể trong việc dự đoán khả năng khách hàng rời bỏ, từ đó mang lại ý nghĩa thực tiễn cho hoạt động kinh doanh.
Đặc trưng có ảnh hưởng tích cực mạnh nhất là total_hashtag_after_last_order với hệ số hồi quy dương lớn. Điều này cho thấy khách hàng có xu hướng sử dụng nhiều hashtag sau đơn hàng gần nhất thường có mức độ tương tác cao hơn và khả năng tiếp tục mua hàng cũng lớn hơn. Đây là dấu hiệu tích cực, thể hiện sự quan tâm của khách hàng đến sản phẩm hoặc thương hiệu, và có thể được xem là một chỉ số hành vi giúp nhận diện khách hàng trung thành.
Ngược lại, một số đặc trưng như totalcompleted_after_upload và total_calls_before_last_order lại có hệ số hồi quy âm, cho thấy mối liên hệ tiêu cực với hành vi tiếp tục mua hàng. Cụ thể, nếu khách hàng hoàn thành quá nhiều hành động sau khi tải lên thông tin, hoặc nhận nhiều cuộc gọi trước đơn hàng gần nhất, thì khả năng rời bỏ sẽ tăng cao. Kết quả này có thể phản ánh sự quá tải trong tương tác hoặc cảm giác phiền toái từ phía khách hàng, từ đó dẫn đến giảm thiện cảm và quyết định không tiếp tục sử dụng dịch vụ.
Ngoài ra, đặc trưng update_discountrate cũng cho thấy ảnh hưởng tích cực nhất định đến hành vi giữ chân khách hàng. Việc cập nhật chính sách giảm giá có thể tạo động lực thúc đẩy khách hàng quay lại sử dụng dịch vụ, đặc biệt trong bối cảnh cạnh tranh cao trên các nền tảng thương mại điện tử.
Các đặc trưng như dpn_userid hay dpn_spbicityid có hệ số ảnh hưởng rất nhỏ, gần bằng 0, cho thấy vai trò không đáng kể trong mô hình dự báo. Những biến này có thể được cân nhắc loại bỏ trong quá trình tinh gọn mô hình nhằm giảm độ phức tạp và tăng hiệu quả tính toán.
Tổng thể, việc xác định và phân tích các đặc trưng có ảnh hưởng đến hành vi rời bỏ không chỉ giúp nâng cao chất lượng mô hình dự báo, mà còn cung cấp cơ sở quan trọng để doanh nghiệp xây dựng các chiến lược giữ chân khách hàng một cách chủ động và hiệu quả hơn.
Đề xuất giải pháp
Dựa trên những phát hiện từ quá trình phân tích hành vi khách hàng và ứng dụng mô hình hồi quy logistic và rừng ngẫu nhiên để dự báo khả năng rời bỏ dịch vụ, nghiên cứu đề xuất các hành động cụ thể như sau:
- Phòng Marketing: Cần triển khai các chiến dịch truyền thông cá nhân hóa, hướng đến nhóm khách hàng có nguy cơ churn cao theo kết quả mô hình dự báo. Phối hợp với bộ phận phân tích dữ liệu để lập danh sách khách hàng cần ưu tiên giữ chân, từ đó thiết kế thông điệp phù hợp, ưu đãi chọn lọc và thời điểm tiếp cận hiệu quả.
- Phòng Chăm sóc khách hàng (CRS): Cần sử dụng kết quả dự báo churn để phân nhóm khách hàng và ưu tiên tiếp xúc chủ động với nhóm có nguy cơ rời bỏ cao, qua điện thoại, email hoặc các kênh cá nhân khác. Thiết lập các tiêu chuẩn chăm sóc riêng biệt dựa trên nhóm churn (cao – trung bình – thấp) như tần suất chăm sóc, ưu đãi giữ chân hoặc các dịch vụ hỗ trợ bổ sung. Phối hợp với phòng dữ liệu để ghi nhận phản hồi sau mỗi tương tác và cập nhật hành vi mới vào hệ thống.
- Phòng Phân tích dữ liệu (Data): Chịu trách nhiệm xây dựng, huấn luyện và giám sát mô hình dự báo churn định kỳ (theo quý hoặc theo tháng), đảm bảo tính chính xác và cập nhật của mô hình. Kết hợp dữ liệu từ các kênh khác nhau (CRM, web, social media...) để mở rộng tập biến đầu vào, từ đó tăng khả năng phát hiện sớm các dấu hiệu churn tiềm ẩn. Thiết kế dashboard trực quan để các phòng ban khác dễ theo dõi nguy cơ churn theo thời gian thực.
Như vậy, việc áp dụng dự báo khách hàng rời bỏ không chỉ mang lại giá trị cho bộ phận dữ liệu mà cần có sự phối hợp đa chiều giữa marketing, chăm sóc khách hàng và lãnh đạo doanh nghiệp. Các hành động cụ thể và định hướng rõ ràng từ nhà quản trị sẽ là yếu tố then chốt giúp doanh nghiệp tối ưu hóa chiến lược giữ chân và nâng cao trải nghiệm khách hàng trong dài hạn.
Tài liệu tham khảo:
1. A. McAfee, E. Brynjolfsson (2012). Big data: The management revolution, Harvard Business Rev., 90(10), 60–68.
2. A. J. A. Shahmi (2025). E‑commerce Customers Churn Prediction Using Machine Learning. DOI:10.13140/RG.2.2.32009.15204.
3. H. Ren (2025). Machine Learning‑Based Prediction of Customer Churn Risk in E‑commerce, Adv. Econ. Manag. Polit. Sci., 153, 47–52.
4. J. Li (2024). Customer Churn Prediction using Machine Learning: A Case Study of E‑commerce Data, Int. J. Comput. Appl., 186(48), 22–25.
5. P. A. Sunarya, U. Rahardja, S.-C. Chen, Y.-M. Li, M. Hardini (2024). A Comparative Study of Logistic Regression and Random Forest in Predicting E‑Commerce Customer Behavior, J. Appl. Data Sci., 5(1), 100–113.
6. P. A. Sunarya et al. (2024). Deciphering Digital Social Dynamics: A Comparative Study of Logistic Regression and Random Forest in Predicting E‑Commerce Customer Behavior, J. Appl. Data Sci., 5(1).
7. Tuhin Subhra De, Pranjal Singh, Alok Patel (2024). A Machine learning and Empirical Bayesian Approach for Predictive Buying in B2B E‑commerce, arXiv, Mar, https://doi.org/10.48550/arXiv.2403.07843.
8. X. Zhang, F. Guo, T. Chen, L. Pan, G. Beliakov, J. Wu (2023). A Brief Survey of Machine Learning and Deep Learning Techniques for E‑Commerce Research, J. Theor. Appl. Electron. Commer. Res., 18, 2188–2216.
| Ngày nhận bài: 18/4/2026; Ngày hoàn thiện biên tập: 11/6/2026; Ngày duyệt đăng: 24/6/2026 |
Tin liên quan


Các tin khác

Các yếu tố ảnh hưởng đến ý định chuyển đổi từ xe máy xăng sang xe máy điện của sinh viên ngoại tỉnh tại Hà Nội

Phát triển doanh nghiệp logistics tại Việt Nam: Thực trạng và kiến nghị

Chia sẻ tri thức, phong cách lãnh đạo và hành vi làm việc đổi mới của nhân viên ngành du lịch - lữ hành Hà Nội

Ảnh hưởng của công bố thông tin ESG đến năng lực huy động vốn và hiệu quả tài chính của các doanh nghiệp thủy sản xuất khẩu tại Việt Nam

Thực trạng các yếu tố ảnh hưởng đến hỗ trợ của doanh nghiệp nhỏ và vừa do phụ nữ làm chủ trên địa bàn TP. Hà Nội và giải pháp tăng cường hỗ trợ

Ảnh hưởng của chất lượng tương tác doanh nghiệp đến kiến thức nghề nghiệp và niềm tin năng lực bản thân của sinh viên: Nghiên cứu tại Trường Cao đẳng Dược Hà Nội

Nguồn lực công nghệ trong các ngành công nghiệp sáng tạo Việt Nam: Từ ứng dụng đến làm chủ công nghệ

Yếu tố ảnh hưởng đến ý định sử dụng xe buýt điện của học sinh, sinh viên tại TP. Hồ Chí Minh

Chính sách quản lý về phát triển chính quyền số tại Hà Tĩnh: Thực trạng và giải pháp


