


Ứng dụng mô hình PhoBERT trong việc phân loại cảm xúc của khách hàng: Bằng chứng thực nghiệm tại các doanh nghiệp mỹ phẩm Việt Nam
Phạm Minh Triết, Vũ Thị Hồng Ánh
Sinh viên chuyên ngành phân tích dữ liệu kinh doanh, Đại học Công nghiệp Hà Nội
Nguyễn Thị Hồng Duyên
Khoa Kế toán - Kiểm toán, Trường Kinh tế, Đại học Công nghiệp Hà Nội
Email: nguyenthihongduyen@haui.edu.vn
Nguyễn Thị Hoa
Phòng tổng hợp, Trường Kinh tế, Đại học Công nghiệp Hà Nội
Tóm tắt
Nghiên cứu này ứng dụng mô hình PhoBERT trong bài toán phân loại cảm xúc bình luận của khách hàng tại các doanh nghiệp mỹ phẩm ở Việt Nam. Dữ liệu được thu thập, xử lý và huấn luyện trên môi trường Google Colaboratory. Kết quả thực nghiệm cho thấy, mô hình đạt độ chính xác cao và thể hiện khả năng nắm bắt tốt đặc trưng ngữ nghĩa tiếng Việt trong bối cảnh đánh giá sản phẩm mỹ phẩm. Kết quả cung cấp bằng chứng thực nghiệm về tính hiệu quả của các mô hình ngôn ngữ tiền huấn luyện trong phân tích cảm xúc tiếng Việt, đồng thời gợi mở hướng ứng dụng trong quản trị trải nghiệm khách hàng, hỗ trợ doanh nghiệp ra quyết định marketing và hoạch định chiến lược kinh doanh.
Từ khoá: PhoBERT, phân loại cảm xúc, mỹ phẩm, thương mại điện tử, xử lý ngôn ngữ tự nhiên
Abstract
This study applies the PhoBERT model to sentiment classification of customer reviews from cosmetic enterprises in Viet Nam. The data were collected, processed, and trained within the Google Colaboratory environment. Experimental results show that the model achieves high accuracy and demonstrates strong capability to capture Vietnamese semantic characteristics in the context of cosmetic product reviews. The findings provide empirical evidence of the effectiveness of pretrained language models in Vietnamese sentiment analysis and suggest practical applications in customer experience management, marketing decision-making, and business strategy development for enterprises.
Keywords: PhoBERT, sentiment classification, cosmetics, e-commerce, natural language processing
GIỚI THIỆU
Trong bối cảnh chuyển đổi số diễn ra mạnh mẽ, sự phát triển của các nền tảng thương mại điện tử và mạng xã hội đã tạo ra một lượng lớn dữ liệu văn bản dưới dạng bình luận, đánh giá và phản hồi của khách hàng. Đặc biệt, ngành mỹ phẩm là một lĩnh vực có mức độ cạnh tranh cao và chịu ảnh hưởng mạnh bởi cảm nhận người tiêu dùng, trong đó các ý kiến trực tuyến đóng vai trò quan trọng trong việc hình thành quyết định mua hàng và xây dựng hình ảnh thương hiệu. Sự gia tăng nhanh chóng của các nguồn dữ liệu này vừa mở ra cơ hội khai thác thông tin giá trị, vừa đặt ra thách thức lớn về xử lý và phân tích dữ liệu một cách hiệu quả.
Ngày nay, sự phát triển của trí tuệ nhân tạo (AI), đặc biệt là các mô hình ngôn ngữ tiền huấn luyện dựa trên kiến trúc Transformer, đã tạo ra bước tiến quan trọng trong bài toán phân tích văn bản. Mô hình BERT do Devlin và cộng sự (2019) đề xuất đã chứng minh hiệu quả vượt trội trong nhiều tác vụ xử lý ngôn ngữ tự nhiên (Natural Language Processing - NLP). Trên nền tảng đó, PhoBERT mô hình ngôn ngữ được tiền huấn luyện chuyên biệt cho tiếng Việt được phát triển nhằm tối ưu khả năng nắm bắt đặc trưng ngữ nghĩa và cú pháp của tiếng Việt, từ đó nâng cao hiệu quả trong các bài toán phân loại văn bản.
Xuất phát từ yêu cầu thực tiễn của các doanh nghiệp mỹ phẩm tại Việt Nam trong việc khai thác dữ liệu phản hồi khách hàng, nghiên cứu này tập trung ứng dụng mô hình PhoBERT cho bài toán phân loại cảm xúc bình luận (tích cực, tiêu cực, trung lập). Hệ thống được xây dựng nhằm tự động hóa quá trình xử lý và phân tích dữ liệu văn bản, từ đó cung cấp bằng chứng thực nghiệm về tính hiệu quả của mô hình trong bối cảnh tiếng Việt. Kết quả nghiên cứu không chỉ góp phần khẳng định tiềm năng ứng dụng của các mô hình ngôn ngữ tiền huấn luyện trong phân tích dữ liệu phi cấu trúc mà còn mang lại hàm ý thực tiễn cho doanh nghiệp trong quản trị trải nghiệm khách hàng và ra quyết định dựa trên dữ liệu.
CƠ SỞ LÝ THUYẾT VÀ PHƯƠNG PHÁP NGHIÊN CỨU
Cơ sở lý thuyết
Trí tuệ nhân tạo (AI) là lĩnh vực khoa học máy tính hướng đến việc mô phỏng các năng lực trí tuệ của con người như học tập, suy luận và xử lý ngôn ngữ (Russell và Norvig, 2010). Trong đó, học máy (Machine Learning) và học sâu (Deep Learning) đóng vai trò nền tảng, cho phép hệ thống tự động học từ dữ liệu và trích xuất đặc trưng từ dữ liệu phi cấu trúc như văn bản (Mitchell, 1997). Nhờ khả năng xử lý dữ liệu lớn và tự động hóa phân tích, AI ngày càng được ứng dụng rộng rãi trong thương mại điện tử và quản trị quan hệ khách hàng.
Trong bối cảnh ngành mỹ phẩm tại Việt Nam phát triển mạnh trên các nền tảng trực tuyến, khối lượng lớn bình luận và đánh giá của khách hàng đặt ra thách thức cho phương pháp phân tích thủ công do tốn thời gian và thiếu chính xác. AI đã chứng minh hiệu quả trong việc tự động hóa phân tích cảm xúc và khai thác ý kiến từ dữ liệu văn bản. Sự xuất hiện của các mô hình ngôn ngữ tiền huấn luyện dựa trên kiến trúc Transformer, đặc biệt là PhoBERT - mô hình được tối ưu cho tiếng Việt tạo tiền đề quan trọng cho việc nâng cao độ chính xác trong phân loại cảm xúc. Điều này mở ra khả năng ứng dụng hiệu quả AI trong việc phân tích phản hồi khách hàng tại các doanh nghiệp mỹ phẩm Việt Nam.
Big Data (dữ liệu lớn) là các tập dữ liệu có quy mô khổng lồ, phức tạp và đa dạng, vượt quá khả năng xử lý của các phương pháp truyền thống (Chen và cộng sự, 2014). Theo Gandomi và Haider (2015), Big Data không chỉ lớn về khối lượng mà còn đòi hỏi các công cụ phân tích tiên tiến để trích xuất giá trị thực tiễn từ dữ liệu. Ban đầu, Big Data được mô tả qua 3 đặc trưng cơ bản, hay còn gọi là “3V”: Volume (khối lượng dữ liệu lớn), Variety (đa dạng về loại hình và nguồn gốc dữ liệu) và Velocity (tốc độ xử lý và cập nhật dữ liệu thời gian thực). Sau này, mô hình được mở rộng thành “5V” bằng cách bổ sung Veracity (độ chính xác, loại bỏ nhiễu) và Value (giá trị kinh tế - xã hội mà dữ liệu mang lại). Những đặc trưng này giúp Big Data hỗ trợ giải quyết các vấn đề phức tạp trong nhiều lĩnh vực, từ marketing đến nghiên cứu khoa học.
Xử lý ngôn ngữ tự nhiên NLP - Text Classification là lĩnh vực quan trọng giúp máy tính hiểu và tương tác với ngôn ngữ con người, từ dịch máy đến phân tích cảm xúc (Manning, 2008). Sự phát triển của học sâu, đặc biệt các mô hình Transformer như BERT (Vaswani và cộng sự, 2017), đã nâng cao khả năng nắm bắt ngữ cảnh và ngữ nghĩa, vượt trội so với các phương pháp truyền thống như Naive Bayes hay SVM. Quá trình NLP bao gồm các bước chính: tiền xử lý văn bản (loại bỏ nhiễu, chuẩn hóa), phân tích cú pháp và ngữ nghĩa, cùng các nhiệm vụ như phân loại văn bản và phân tích cảm xúc (sentiment analysis).
NLP mang lại cơ hội lớn trong thương mại điện tử và chăm sóc khách hàng, giúp tự động phân loại bình luận, nhận diện cảm xúc (tích cực, tiêu cực) và phát hiện đánh giá giả mạo, từ đó cải thiện trải nghiệm người dùng (Dan Jurafsky và cộng sự, 2009). Tuy nhiên, thách thức vẫn tồn tại như sự mơ hồ ngôn ngữ, thiếu dữ liệu cho ngôn ngữ ít tài nguyên (như tiếng Việt), định kiến mô hình và nhu cầu tính toán cao. Trong nghiên cứu này, mô hình PhoBERT - phiên bản BERT tối ưu cho tiếng Việt được áp dụng để xử lý dữ liệu bình luận khách hàng từ doanh nghiệp mỹ phẩm Việt Nam, nhằm khắc phục hạn chế ngôn ngữ và cung cấp bằng chứng thực nghiệm về hiệu quả phân loại cảm xúc, góp phần nâng cao chiến lược kinh doanh dựa trên dữ liệu.
PhoBERT (Bidirectional Encoder Representations from Transformers) là một mô hình ngôn ngữ tiên tiến được đề xuất bởi VinAI Research vào năm 2020, nhằm khắc phục hạn chế của các mô hình đa ngôn ngữ trong việc xử lý tiếng Việt. Mô hình này được xây dựng dựa trên kiến trúc RoBERTa là một biến thể cải tiến của BERT nhưng tập trung tối ưu hóa cho đặc thù ngôn ngữ Việt Nam, với các cải tiến về huấn luyện và xử lý dữ liệu để nâng cao hiệu suất trên các nhiệm vụ NLP địa phương (Nguyen và Nguyen, 2020).
Giống như RoBERTa, PhoBERT sử dụng kiến trúc Transformer đa lớp và cơ chế tự chú ý (self-attention) để nắm bắt ngữ cảnh sâu sắc, nhưng điểm khác biệt quan trọng nằm ở tokenizer WordPiece được tùy chỉnh cho tiếng Việt, hỗ trợ phân tích từ ghép, dấu thanh và subword, giúp mô hình xử lý hiệu quả dữ liệu văn bản tiếng Việt mà không bị phân mảnh không cần thiết. PhoBERT loại bỏ các nhiệm vụ không phù hợp với ngôn ngữ đơn lẻ và chỉ tập trung vào Masked Language Modeling (MLM) với dynamic masking che ngẫu nhiên các token trong từng batch huấn luyện - thay vì static masking cố định, từ đó tăng khả năng tiếp xúc đa dạng với ngữ cảnh và cải thiện độ chính xác hiểu ngôn ngữ. Mô hình được huấn luyện trên tập dữ liệu văn bản quy mô lớn khoảng 20GB từ các nguồn tiếng Việt như Wikipedia, báo chí và sách, giúp PhoBERT vượt trội hơn về khả năng nắm bắt ngữ nghĩa và cấu trúc ngôn ngữ địa phương trong các tác vụ như phân tích cảm xúc, phân loại văn bản và nhận dạng thực thể.
PhoBERT có khả năng tổng quát hóa tốt hơn đối với từ vựng tiếng Việt hiếm gặp nhờ bộ từ điển mở rộng lên tới 64.000 token, bao quát các yếu tố văn hóa và khẩu ngữ đặc trưng. Bên cạnh đó, trong quá trình tinh chỉnh (fine-tuning), PhoBERT có thể kết hợp với các kỹ thuật học nâng cao như học đa nhiệm (multi-task learning) và học chuyển tiếp (transfer learning) để thích ứng nhanh chóng với các ứng dụng cụ thể, chẳng hạn như phân loại cảm xúc từ bình luận khách hàng. PhoBERT là một mô hình học sâu thể hiện hiệu suất vượt trội trên nhiều tác vụ xử lý ngôn ngữ tự nhiên tiếng Việt, đặc biệt trong bối cảnh yêu cầu về độ chính xác và khả năng thích ứng ngày càng cao đối với các mô hình ngôn ngữ địa phương hóa.
Thương mại điện tử là hình thức trao đổi hàng hóa và dịch vụ qua các nền tảng trực tuyến, kết nối người mua - bán một cách nhanh chóng, vượt qua hạn chế không gian và thời gian của thương mại truyền thống (Rahayu và Day, 2015). Lĩnh vực này phát triển mạnh nhờ sự phổ biến của internet, thiết bị di động và công nghệ thanh toán, thúc đẩy chuyển đổi số toàn diện (Bawack và cộng sự, 2022). Các mô hình chính bao gồm B2C (doanh nghiệp bán trực tiếp cho người tiêu dùng, như Shopee), B2B (giao dịch giữa doanh nghiệp), C2C (người tiêu dùng trao đổi qua trung gian như Chợ Tốt) và C2B (người tiêu dùng cung cấp cho doanh nghiệp), giúp mở rộng thị trường toàn cầu và nâng cao trải nghiệm khách hàng.
Trong bối cảnh doanh nghiệp mỹ phẩm Việt Nam, nghiên cứu này áp dụng PhoBERT để phân loại cảm xúc từ bình luận khách hàng trên các nền tảng như Shopee và Lazada, cung cấp bằng chứng thực nghiệm về khả năng cải thiện chiến lược marketing dựa trên dữ liệu địa phương.
Phương pháp nghiên cứu
Phương pháp nghiên cứu
Nghiên cứu sử dụng phương pháp định lượng kết hợp với kỹ thuật NLP nhằm phân loại cảm xúc trong các bình luận của khách hàng. Mô hình ngôn ngữ tiền huấn luyện PhoBERT được sử dụng để khai thác đặc trưng ngữ nghĩa của tiếng Việt và thực hiện bài toán phân loại văn bản.
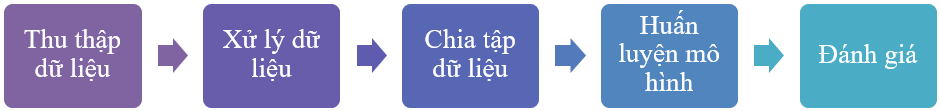
Hình 1: Quy trình nghiên cứu
 |
Nguồn: Nhóm tác giả
Quy trình nghiên cứu được thực hiện qua các bước chính (Hình 1). Trước hết, dữ liệu bình luận của khách hàng được thu thập và tiến hành tiền xử lý nhằm loại bỏ các ký tự không cần thiết, đường dẫn, số và biểu tượng cảm xúc. Tiếp theo, dữ liệu được chuẩn hóa và chuyển đổi sang dạng phù hợp để đưa vào mô hình. Sau đó, dữ liệu được chia thành hai tập gồm tập huấn luyện và tập kiểm tra theo tỷ lệ 70% và 30%.
Mô hình PhoBERT được tinh chỉnh (fine-tuning) cho bài toán phân loại cảm xúc với hai nhãn chính là tích cực và tiêu cực. Sau khi huấn luyện, mô hình được sử dụng để dự đoán cảm xúc của các bình luận trong tập kiểm tra và đánh giá hiệu quả thông qua các chỉ số đo lường phổ biến trong bài toán phân loại văn bản.
Dữ liệu nghiên cứu
Dữ liệu sử dụng trong nghiên cứu bao gồm các bình luận và đánh giá của khách hàng về các sản phẩm mỹ phẩm được thu thập từ các nền tảng thương mại điện tử. Tập dữ liệu gồm 11.578 quan sát với 2 biến chính là rating và processed_comment. Trong đó, biến rating thể hiện mức độ đánh giá của khách hàng đối với sản phẩm theo thang điểm từ 1 đến 5, còn processed_comment là nội dung bình luận của khách hàng sau khi đã được tiền xử lý.
Quá trình tiền xử lý dữ liệu được thực hiện nhằm chuẩn hóa văn bản và loại bỏ các thành phần không cần thiết. Các bước xử lý bao gồm chuyển toàn bộ văn bản về chữ thường, loại bỏ ký tự đặc biệt, đường dẫn và các thành phần nhiễu. Đồng thời, các từ trong bình luận được chuẩn hóa và liên kết bằng dấu gạch dưới nhằm đảm bảo tính nhất quán của dữ liệu trước khi đưa vào mô hình.
Trong nghiên cứu này, nhãn cảm xúc được xác định dựa trên điểm đánh giá của khách hàng. Các bình luận có điểm đánh giá từ 4 đến 5 được gán nhãn tích cực, trong khi các bình luận có điểm đánh giá từ 1 đến 3 được gán nhãn tiêu cực. Sau khi hoàn tất quá trình xử lý và gán nhãn, tập dữ liệu được sử dụng để huấn luyện và đánh giá mô hình PhoBERT.
Các chỉ số được sử dụng để phân tích
Để đánh giá hiệu quả của mô hình PhoBERT trong bài toán phân loại cảm xúc bình luận của khách hàng, nghiên cứu sử dụng các chỉ số đánh giá phổ biến trong bài toán phân loại văn bản, bao gồm Accuracy, Precision, Recall và F1-score.
- Accuracy (độ chính xác) phản ánh tỷ lệ dự đoán đúng của mô hình trên tổng số mẫu trong tập dữ liệu kiểm tra, qua đó đánh giá hiệu suất tổng thể của mô hình.
- Precision thể hiện mức độ chính xác của các dự đoán thuộc một lớp cảm xúc cụ thể, được tính bằng tỷ lệ giữa số dự đoán đúng của lớp đó so với tổng số mẫu được mô hình dự đoán thuộc lớp tương ứng.
- Recall phản ánh khả năng của mô hình trong việc phát hiện đầy đủ các mẫu thực tế thuộc một lớp cảm xúc, được xác định thông qua tỷ lệ giữa số dự đoán đúng của lớp đó so với tổng số mẫu thực tế của lớp.
- F1-score là trung bình điều hòa giữa Precision và Recall, được sử dụng nhằm đánh giá hiệu quả tổng thể của mô hình, đặc biệt trong trường hợp dữ liệu có sự chênh lệch về số lượng giữa các lớp.
Ngoài ra, chỉ số Support được sử dụng để thể hiện số lượng mẫu thực tế của từng lớp cảm xúc trong tập dữ liệu kiểm tra, qua đó cung cấp thông tin về phân bố dữ liệu và hỗ trợ việc đánh giá độ tin cậy của các chỉ số đo lường.
KẾT QUẢ NGHIÊN CỨU
Bảng: Báo cáo phân loại
| Class | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| Negative | 0.9257 | 0.9123 | 0.9190 | 1.038 |
| Positive | 0.9592 | 0.9657 | 0.9624 | 2.216 |
| Accuracy | 0.9487 | 3.254 | ||
| Macro Avg | 0.9425 | 0.9390 | 0.9407 | 3.254 |
| Weighted Avg | 0.9485 | 0.9487 | 0.9486 | 3.254 |
Nguồn: Tổng hợp kết quả từ nhóm tác giả
Theo kết quả (Bảng), mô hình đạt độ chính xác 94,87%, cho thấy phần lớn các bình luận trong tập dữ liệu kiểm tra đã được phân loại đúng. Các chỉ số precision, recall và F1-score của 2 lớp cảm xúc đều đạt giá trị cao, phản ánh khả năng phân loại hiệu quả của mô hình.
Cụ thể, đối với lớp Negative, mô hình đạt precision 0,9257, recall 0,9123 và F1-score 0,9190. Điều này cho thấy mô hình có khả năng nhận diện khá tốt các bình luận mang cảm xúc tiêu cực, mặc dù vẫn còn một số trường hợp bị nhầm lẫn với lớp tích cực.
Đối với lớp Positive, mô hình đạt precision 0,9592, recall 0,9657 và F1-score 0,9624, thể hiện khả năng dự đoán chính xác và ổn định đối với các bình luận tích cực.
Bên cạnh đó, các giá trị macro average và weighted average của các chỉ số precision, recall và F1-score đều đạt trên 0,94, cho thấy hiệu suất của mô hình tương đối cân bằng giữa các lớp dữ liệu. Điều này chứng tỏ mô hình PhoBERT có khả năng khai thác hiệu quả đặc trưng ngữ nghĩa của tiếng Việt trong quá trình phân loại cảm xúc.
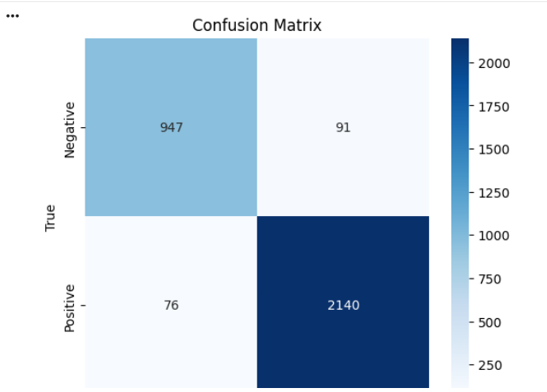
Để phân tích chi tiết hơn kết quả dự đoán của mô hình, ma trận nhầm lẫn (Confusion Matrix) được sử dụng nhằm thể hiện số lượng mẫu được phân loại đúng và sai giữa các lớp cảm xúc.
Kết quả (Hình 2) cho thấy, trong tổng số 3.254 bình luận thuộc tập kiểm tra, có 947 bình luận tiêu cực được phân loại đúng là tiêu cực và 2.140 bình luận tích cực được phân loại đúng là tích cực. Tuy nhiên, vẫn tồn tại một số trường hợp phân loại sai, bao gồm 91 bình luận tiêu cực bị dự đoán nhầm thành tích cực và 76 bình luận tích cực bị dự đoán nhầm thành tiêu cực.
Hình 2: Ma trận nhầm lẫn
 |
Nguồn: Tổng hợp kết quả từ nhóm tác giả
Kết quả từ ma trận nhầm lẫn cho thấy, số lượng dự đoán đúng chiếm tỷ lệ lớn so với số lượng dự đoán sai, qua đó khẳng định hiệu quả của mô hình trong việc phân loại cảm xúc bình luận của khách hàng. Đồng thời, sự chênh lệch không quá lớn giữa các lỗi phân loại cũng cho thấy mô hình duy trì được sự ổn định khi xử lý dữ liệu văn bản tiếng Việt.
Nhìn chung, kết quả thực nghiệm cho thấy mô hình PhoBERT có khả năng phân loại cảm xúc với độ chính xác cao và hiệu suất ổn định. Điều này chứng minh tiềm năng ứng dụng của mô hình trong việc phân tích phản hồi khách hàng trong lĩnh vực thương mại điện tử, đặc biệt đối với ngành mỹ phẩm tại Việt Nam. Việc ứng dụng các mô hình ngôn ngữ tiền huấn luyện như PhoBERT có thể hỗ trợ doanh nghiệp khai thác hiệu quả dữ liệu phản hồi của khách hàng, từ đó nâng cao chất lượng sản phẩm, cải thiện trải nghiệm người dùng và hỗ trợ quá trình ra quyết định kinh doanh dựa trên dữ liệu.
KẾT LUẬN
Nghiên cứu này đã ứng dụng mô hình ngôn ngữ tiền huấn luyện PhoBERT trong bài toán phân loại cảm xúc bình luận của khách hàng đối với các sản phẩm mỹ phẩm tại Việt Nam. Kết quả thực nghiệm cho thấy mô hình đạt độ chính xác 94,87%, đồng thời đạt giá trị cao đối với các chỉ số Precision, Recall và F1-score. Điều này cho thấy PhoBERT có khả năng nắm bắt hiệu quả đặc trưng ngữ nghĩa của tiếng Việt và hoạt động ổn định trong bài toán phân loại cảm xúc văn bản.
Kết quả nghiên cứu khẳng định tiềm năng ứng dụng của các mô hình ngôn ngữ tiền huấn luyện trong việc khai thác dữ liệu phản hồi của khách hàng trên các nền tảng thương mại điện tử. Việc áp dụng các mô hình như PhoBERT có thể giúp doanh nghiệp tự động phân tích ý kiến khách hàng, từ đó nâng cao chất lượng sản phẩm, cải thiện trải nghiệm người dùng và hỗ trợ quá trình ra quyết định kinh doanh dựa trên dữ liệu.
Tuy nhiên, nghiên cứu vẫn tồn tại một số hạn chế. Thứ nhất, nghiên cứu mới chỉ sử dụng một mô hình duy nhất là PhoBERT mà chưa thực hiện so sánh với các mô hình xử lý ngôn ngữ tự nhiên khác. Thứ hai, tập dữ liệu nghiên cứu vẫn còn giới hạn về quy mô và nguồn dữ liệu. Do đó, trong các nghiên cứu tiếp theo có thể mở rộng tập dữ liệu, đồng thời so sánh hiệu suất giữa các mô hình khác nhau như BERT, ELECTRA hoặc các mô hình Transformer mới nhằm nâng cao độ tin cậy của kết quả nghiên cứu.
Tài liệu tham khảo:
1. Bawack, R. E., Wamba, S. F., Carillo, K. D. A., and Akter, S. (2022). Artificial intelligence in e-commerce: A bibliometric study and literature review. Electronic Markets, 32(1), 297-338.
2. Chen, M., Mao, S., and Liu, Y. (2014). Big data: A survey. Mobile networks and applications, 19(2), 171-209.
3. Dan Jurafsky., and James H. Martin (2009). Speech and language processing: An introduction to natural language processing, computational linguistics, and speech recognition. Pearson/Prentice Hall.
4. Devlin, J., Chang, M., Lee, K., and Toutanova, K. (2019). BERT: Pre-training of deep bidirectional transformers for language understanding. In Proceedings of NAACL-HLT 2019.
5. Gandomi, A., and Haider, Z. (2015). Beyond the hype: big data concepts, methods, and analytics. International Journal of Information Management.
6. Mitchell, T. M. (1997). Does machine learning really work?. AI magazine, 18(3), 11-11.
7. Manning, C. D. (2008). Introduction to information retrieval. Syngress Publishing.
8. Nguyen, D. Q., and Nguyen, A. T. (2020, November). PhoBERT: Pre-trained language models for Vietnamese. In Findings of the association for computational linguistics: EMNLP 2020 (1037-1042).
9. Rusell, S., and Norvig, P. (2010). Artificial intelligence: A modern approach. Prentice Hall.
10. Rahayu, R., and Day, J. (2015). Determinant factors of e-commerce adoption by SMEs in developing country: evidence from Indonesia. Procedia-social and behavioral sciences, 195, 142-150.
11. Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., and Polosukhin, I. (2017). Attention is all you need. Proceedings of the 31st International Conference on Neural Information Processing Systems (NeurIPS 2017), 30, 5998-6008.
| Ngày nhận bài: 11/3/2026; Ngày hoàn thiện biên tập: 18/5/2026; Ngày duyệt đăng: 21/5/2026 |
Các tin khác

Quảng cáo livestream và doanh số ngoại phiên: Bằng chứng bước đầu từ Công ty TNHH IGA Việt Nam

Chiến lược cạnh tranh của doanh nghiệp nhỏ và vừa tại Việt Nam trong bối cảnh chuyển đổi số

Tác động của chuyển đối số và marketing đến kết quả kinh doanh của các doanh nghiệp nội thất tại TP. Hồ Chí Minh

Mối quan hệ đổi mới sáng tạo số, năng lực số, tính linh hoạt tổ chức lên hiệu quả hoạt động doanh nghiệp: Trường hợp các doanh nghiệp thực phẩm tại TP. Hồ Chí Minh

Doanh nghiệp công nghiệp hỗ trợ: Tổng quan và hàm ý chính sách cho Việt Nam

Đánh giá đa tiêu chí năng lực cạnh tranh của doanh nghiệp bất động sản tại TP. Hồ Chí Minh: Tiếp cận từ phương pháp phân tích AHP và IPA

Giải pháp nâng cao sự hài lòng, thúc đẩy ý định quay lại của khách hàng tại chuỗi cà phê thương hiệu Nón Coffee ở TP. Hồ Chí Minh

Tác động phi tuyến của chuyển đổi xanh đến giá trị thị trường của các doanh nghiệp niêm yết tại Việt Nam

Đổi mới sản phẩm xanh, đổi mới quy trình xanh và hiệu quả hoạt động của doanh nghiệp chế biến thực phẩm: Đề xuất mô hình nghiên cứu


